Dais Technology bir insurtech. Platform, perakende iş ortakları için koruma planları satıyor ve servis ediyor; kayıt sistemi Postgres—üstelik workflow state'lerini iç içe JSON olarak tutan JSONB kolonlarla, bazen JSON içinde serialize edilmiş JSON'la. Arama ise AWS üzerinde Elasticsearch'te: transaction ID, müşteri adı ya da yarım SKU yazıldığında UI satış ve claim kayıtlarında anında cevap vermek zorunda.
İlk görüşmeden çıkan semptom listesi kısa ve dürüsttü: indexing latency, web sayfasında güncellemenin geç görünmesi ("muhtemelen cache"), aggregation soruları, full-text search davranışı, cluster AWS'te. Bu liste beş ayrı hikâye değil, tek hikâye çıktı.
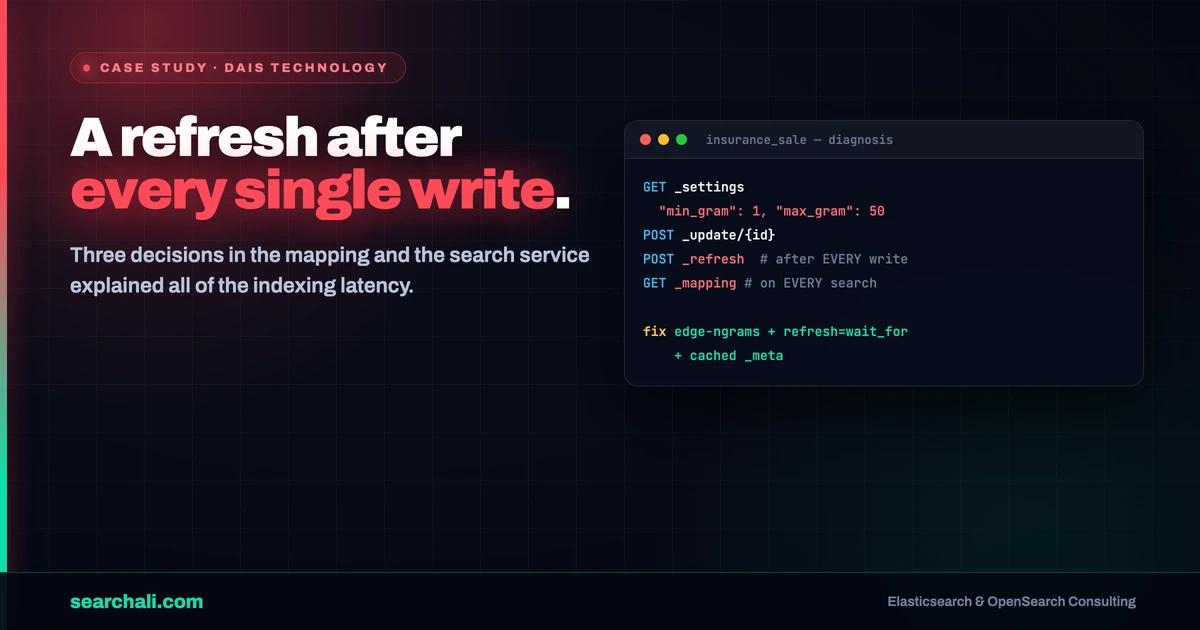
Kısa cevap: Dais, Postgres satırlarını—JSONB'yi ->/->> operatörleriyle düzleştirerek—data + metadata şeklinde kurgulanmış entity bazlı Elasticsearch index'lerine sync ediyor; rol ve tenant güvenliği mapping'in _meta bloğunda duruyor ve sorgu anında filtre olarak uygulanıyor. Latency şikâyetleri üç kararın bileşkesiydi: her text alanının 1-50 karakterlik bütün parçalarını index'leyen ngram tokenizer, her doküman yazımından sonra explicit refresh ve her aramada bir get_mapping turu. Üçü de kullanıcı deneyimini bozmadan düzeltilebilir.
Sorun
Ortam, us-west-2'de Amazon OpenSearch Service: 7.1 ve 7.10 Elasticsearch-engine domain'leri, hepsi VPC-only, her environment (dev, integration, UAT, production) için ayrı domain. Ürünün kalbi insurance_sale ve insurance_claim index'leri: ekip ve iş ortakları sürekli arama yapıyor; Postgres'teki her satış ve claim güncellemesi hızla aranabilir olmalı.
Pipeline'ın iki sahibi var. Bir Java servisi alan alan index tanımlarını (sale.json, claim.json) tutuyor ve index'leri kodla oluşturuyor. Python tabanlı bir search mikroservisi frontend için Elasticsearch client'ını sarıyor: sorguları kuruyor, dokümanları doc_as_upsert update olarak yazıyor, yetkilendirmeyi uyguluyor. Database sync tarafında Logstash JDBC prototipi de vardı—Postgres driver jar, info ->> 'customer' tarzı JSON düzleştiren SELECT, cron schedule.
Şikâyetler kullanıcıya dokunuyordu: yazma yavaş hissettiriyor, yeni düzenlenen bir satış bazen sayfada hemen görünmüyordu.
Teşhis
1-50 ngram tokenizer
Indexing latency'nin adresi mapping'di. Aranabilir bütün text alanları—isimler, adresler, SKU'lar, ürün açıklamaları—custom ngram_analyzer ile analiz ediliyordu:
"tokenizer": {
  "ngram_tokenizer": {
    "type": "ngram",
    "min_gram": "1",
    "max_gram": "50",
    "token_chars": ["letter", "digit", "punctuation", "symbol", "custom"],
    "custom_token_chars": "_\\+/-"
  }
}
Elasticsearch'ün bunu kabul etmesi için max_ngram_diff: 49 da eklenmiş. Kazanç "her yerde her substring eşleşsin"; bedel ağır: 50 karakterlik bir ürün açıklaması alan başına, doküman başına bin mertebesinde token üretiyor. Index boyutu, segment merge baskısı ve doküman başına indexleme süresi bununla ölçekleniyor. Arama tarafı ayrı bir partial_text_search analyzer (whitespace + lowercase) kullandığı için sorgular ucuzdu—bütün acı yazma anında toplanmıştı. Elastic'in ngram tokenizer dokümanı max_ngram_diff default'unu 1 tutarak bunu zaten ima ediyor.
Her yazmada refresh
Python servisi her doküman yazımını—ve her bulk'ı—explicit indices.refresh() ile bitiriyordu. "Web sayfasında güncelleme gecikiyor" raporunun açıklaması bu: ekip yazmaları senkron görünür kılmak için refresh'i zorlamış, karşılığını indexing throughput ile ödemişti. Yazma başına refresh bir sürü minik segment üretir ve Elasticsearch'ün batching modelini boşa çıkarır; yük altında cluster'ı yavaş hissettirmenin en garantili yollarından biridir.
Arama başına mapping okuması
Rol bazlı güvenlik akıllıca bir yerde duruyordu: mapping'in _meta bloğu searchable_fields (boost'larla, ör. data.transactionId^10) ve permission_metadata tutuyor—öncelik sıralı bir rol listesi; admin rolü serbest geçerken perakende-ortak rolü storeCode ile filtrelenmek zorunda. Search servisi bu _meta'yı her istekte get_mapping ile okuyor, sonra operator: and ile cross_fields multi_match, metadata.tenantId.keyword üzerinde term filtresi, rol filtreleri ve rol eşleşmezse geçilmez bir filtre kuruyordu. Tasarım doğru—ama neredeyse hiç değişmeyen veri için her sorguda ekstra get_mapping turu hem latency hem cluster-state trafiği ekliyor.
Alışkanlıktan sharding
Entity index'leri 5 primary shard + 1 replica taşıyordu—bir sizing kararı değil, 7.x öncesi default'un devamı. Tek entity'lik bir arama index'i için bu, küçük segmentleri ve shard başına overhead'i cluster geneline çarpan etkisiyle yayar.
Çözüm
Öneriler kullanıcıya dönük sözleşmeyi bozmadan kuruldu:
- Ngram'ı sınırla.
min_gram/max_gram'i makul bir pencereye çek (prefix için edge-ngram, infix için 2-3'ten ~10'a), ya da prefix senaryolarınısearch_as_you_type/keyword wildcard'a taşı. Paketteki en büyük indexing-latency kolu bu. - Refresh-per-write'ı kaldır. UI'nin beklediği spesifik yazmada
refresh=wait_for, gerisinde index seviyesinderefresh_interval. Aynı read-your-own-write deneyimi, segment fırtınası yok. _meta'yı cache'le. Searchable field'lar ve permission metadata sorgu başına değil deploy başına değişir—serviste kısa TTL ile cache'le,get_mapping'i hot path'ten çıkar.- Shard'ları doğru boyutlandır. Bu veri hacminde entity index başına bir primary (+ replica); büyüme bilinçli olsun, default'la değil.
- İyi parçaları koru.
dynamic: falsemapping,data/metadatadoküman ayrımı, tenant term filtreleri ve boost'lumulti_matchmulti-tenant entity aramanın tam olması gereken hali. Postgres JSON operatörlü Logstash JDBC hattı da app seviyesindeki upsert'in yanında meşru bir sync seçeneği.
Ayrıca production domain'e karşı container tabanlı Metricbeat monitoring kurduk; indexing baskısı ve refresh davranışı anekdot olmaktan çıkıp görünür hale geldi—searchali.com monitoring tarafında savunduğum görünürlük argümanının aynısı.
Sonuçlar
Sadece evidence pack'in desteklediği kadar:
| Madde | Kanıt |
|---|---|
| Indexing/update latency kök nedenleri belirlendi | 1-50 ngram mapping, her yazmada refresh, sorgu başına get_mapping (kod + mapping) |
| Multi-tenant arama güvenliği sorgu anı filtreleriyle doğrulandı | _meta permission metadata + tenant term filtresi |
| Postgres JSON → Elasticsearch sync desenleri belgelendi | ->> düzleştirmeli JDBC/Logstash prototipi; app seviyesinde doc_as_upsert |
| Cluster monitoring devreye alındı | Production domain'e Metricbeat container, 10 sn pull aralığı |
Öncesi/sonrası latency yüzdeleri, index boyutları veya throughput sayıları: kaynak pakette yok, burada da yok.
Öğrendiklerimiz
- Ngram, indexleme anından alınmış kredidir.
min_gram: 1, max_gram: 50her alanın ~O(uzunluk × 50) token ödemesi demek. Pencereyi sınırla ya da edge-ngram kullan. - Asla yazma başına
refreshyapma. Önemli tek yazmadarefresh=wait_for; gerisirefresh_interval. - "Sayfa eski veri gösteriyor" çoğu zaman refresh-mi-cache-mi sorusudur. Bir forced refresh daha eklemeden önce hangi katman olduğunu teşhis et.
- Mapping'ten gelen config'i cache'le.
_metasearchable field ve permission için harika bir yer—sorgu başına okumak değil. - Shard sayısı karardır, default değil. Mütevazı bir entity index'ine beş primary, 7.x ataletidir.
- Postgres JSON temiz düzleşir. JDBC statement içinde
info -> 'items' ->> 'qty', JSON'u pipeline'da yeniden şekillendirmekten iyidir.
Kaynağı Postgres olan, AWS Elasticsearch/OpenSearch üzerinde koşan ve açıklayamadığınız latency üreten bir arama mı var? Tam olarak yaptığım iş bu → searchali.com