CRM verisi üzerine doğal dilli arama kuran bir AI startup'ının kurucu ekibiyle oturduk. Python job'ları CRM API'sinden kayıt çekiyor, web crawling elle tetikleniyor, ürün de "bana bir Elasticsearch mühendisi bul, bir yıldan eski olanları eleme" gibi bir cümleyi query'ye çeviriyor. Ana sorunu kendi cümleleriyle söylediler: "index'i tazelemek problem."
Bu tek cümlenin içinde birbirinden tamamen farklı iki mühendislik problemi saklı; ikisini karıştırmak, sahada en sık gördüğüm tazelik hatası. Bu rehber önce bu ikisini ayırıyor, sonra aynı görüşmede geçen ve her crawl + CRM stack'ini ısıran iki konuyu ele alıyor: silinen kayıtlar ve index-per-tenant tasarımı.
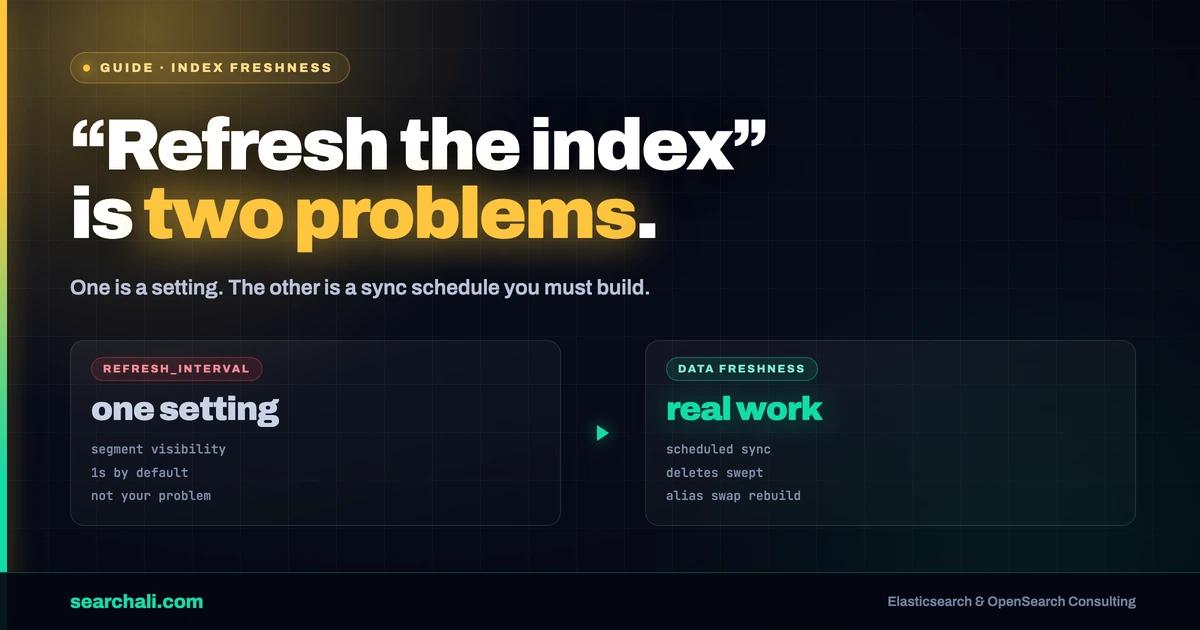
Kısa cevap: "Index'i tazelemek" iki ayrı şey demek. (1) Elasticsearch'ün kendi refresh'i—yeni yazılan dokümanın aramada görünür olması; refresh_interval ile kontrol edilir, tasarım gereği near-real-time'dır. (2) Veri tazeliği—yeni, değişen ve silinen kaynak kayıtların index'e hiç ulaşıp ulaşmadığı. İlki tek satırlık bir ayar. İkincisi pipeline'ınızın işi: sync'i zamanlayın, silmeleri last_synced taraması ya da alias arkasında rebuild ile yansıtın, query'ye de recency filter koyun ki bayat dokümanlar sıralamaya girmesin.
"Index'i tazelemek"in iki anlamı
Elasticsearch refresh: segment görünürlüğü
Elasticsearch near-real-time çalışır. Index'lediğiniz doküman anında kalıcıdır ama aranabilir hale ancak bir sonraki refresh'te gelir—aktif aranan index'lerde varsayılan olarak saniyede bir. Bunu refresh_interval yönetir:
PUT /candidates/_settings
{
  "index": { "refresh_interval": "30s" }
}
Batch sync job'larıyla beslenen bir CRM/aday arama yükünde kimsenin 1 saniyelik görünürlüğe ihtiyacı yok. refresh_interval'ı 30s ya da 60s yapmak segment churn'ünü ve indexing maliyetini bedavaya düşürür. Tek bir yazımın hemen görünmesi gerekiyorsa (kullanıcı kaydı düzenleyip sayfayı yeniledi), tüm index'i sıkıştırmak yerine o istekte ?refresh=wait_for kullanın. Ayrıntılar Elastic'in near-real-time search dokümanında.
"Refresh sorununuz" buysa bir öğleden sonra çözülür. Ama genelde bu değildir.
Veri tazeliği: pipeline'ın işi
O toplantıdaki asıl dert ikinci anlamdı: index kaynaktan uzaklaşıyor. Crawling elle tetikleniyordu—yani tazelik, birinin düğmeye basmayı hatırlamasına bağlı. Çözüm sıkıcı ama pazarlıksız: sync'i takvime bağlayın (cron, Airflow, elinizde ne varsa), CRM'in modified-since cursor'ıyla incremental yapın ve dokunduğunuz her dokümana last_synced timestamp'i yazın. Aşağıdaki her şeyin omurgası bu alan.
Silinen kayıtlarla başa çıkmak
CRM'de silinen kayıt kendini ihbar etmez. Incremental sync yalnızca var olan kayıtları görür; silmeler index'te sessizce bayat doküman olarak birikir—startup'ın problem listesindeki "deleted records" maddesi tam olarak bu. İki çalışan desen var:
last_synced ile tarama
Her full pass canlı dokümanlara last_synced damgası basıyorsa, pass'in dokunmadığı her şey ölüdür. Süpürün:
POST /candidates/_delete_by_query
{
  "query": {
    "range": { "last_synced": { "lt": "now-2d" } }
  }
}
Periyodik full pass'i kaldırabiliyorsanız bu yöntem işler. Pass bittikten sonra ve bir sync döngüsünden geniş bir marjla çalıştırın ki yavaşlayan bir job canlı veriyi silmesin.
Alias arkasında rebuild
Veri seti küçük-orta boyuttaysa (tek tenant'lık bir CRM genelde öyledir) en temiz cevap şu: her şeyi taze bir index'e yeniden yazın, alias'ı atomik olarak çevirin. Silinenler kopyalanmadıkları için tanım gereği yok olur.
POST /_aliases
{
  "actions": [
    { "remove": { "index": "candidates_v41", "alias": "candidates" } },
    { "add":    { "index": "candidates_v42", "alias": "candidates" } }
  ]
}
Uygulama yalnızca candidates alias'ını sorgular. Downtime yok, tombstone muhasebesi yok; mapping değişiklikleri de bedavaya biner. Crawl ile beslenen index'lerde varsayılan önerim budur—çünkü crawler'lar silme bildirmekte CRM'lerden bile kötüdür.
Index per tenant, tek tenant
Ekip index-per-tenant tasarlamıştı—ve tam olarak bir tenant'ları vardı. Doğru içgüdünün fazla erken uygulanmış hali. Index-per-tenant temiz silme (tenant giderse index'i düşürürsünüz), tenant'a özel mapping ve kolay alias-swap rebuild verir. Ama her index shard demek, shard da heap ve cluster-state maliyeti; yüzlerce küçük tenant'ta klasik oversharding problemine varırsınız.
Pragmatik yol: tenant sayısı azken ve veri setleri farklıyken index-per-tenant'ta kalın, veri aksini kanıtlayana kadar index başına tek primary shard kullanın ve ilk günden her fiziksel index'in önüne tenant başına bir alias koyun—böylece küçük tenant'ları ileride tenant_id filter'lı ortak bir index'te birleştirirken uygulama koduna dokunmazsınız.
Cümleden tazelik farkındalıklı query'ye
Notlardaki ürün senaryosu: "bana bir Elasticsearch mühendisi bul — bir yıldan eskiyi eleme." Query'yi hangi LLM ya da parser üretirse üretsin, recency kuralının yeri text matching değil, filter clause'udur:
GET /candidates/_search
{
  "query": {
    "bool": {
      "must": [
        { "match": { "profile": "elasticsearch engineer" } }
      ],
      "filter": [
        { "range": { "updated_at": { "gte": "now-1y/d" } } }
      ]
    }
  }
}
Filter'lar cache'lenir ve skoru bozmaz. Ve bağımlılığa dikkat: bu query ancak updated_at kadar dürüsttür—o da doğrudan sync pipeline'ına döner. Bayat veri üzerindeki tazelik filtresi, yalanları kendinden emin filtrelemekten ibarettir. Eskiyi elemek yerine aşağı sıralamak istiyorsanız, sert kesim yerine updated_at üzerinde gauss decay function ekleyin.
Burada yapmayacağım tek şey performans rakamı vermek: bu evidence paketi bir keşif görüşmesinden ibaret, benchmark yok—olmayan metriği de uydurmam.
Öğrendiklerimiz
- "Refresh"i iki ayrı ticket'a bölün:
refresh_interval(Elasticsearch tarafı, tek ayar) ve pipeline tazeliği (sizin işiniz, asıl mesai). - Batch beslenen arama index'lerinin 1s refresh'e ihtiyacı yok—
30s+ verin, nadir read-your-own-write durumunda?refresh=wait_forkullanın. - Crawl'ı asla elle tetiklemeyin. Incremental sync'i zamanlayın, her dokümana
last_syncedbasın. - Silmeler kendiliğinden sync olmaz:
last_syncedüzerinden_delete_by_queryile süpürün ya da rebuild + alias swap yapın. - İlk günden her fiziksel index'in önüne alias koyun—rebuild ve tenancy değişiklikleri uygulamaya görünmez olur.
- Recency'nin yeri
filterclause'u (now-1y/d): cache'lenir, skoru bozmaz ve ancak sync timestamp'leriniz kadar doğrudur.
Arama index'iniz kaynağından uzaklaşıyorsa ve kimse ne kadar bayat olduğunu söyleyemiyorsa, işe cluster'ı ve pipeline'ı birlikte izlemekten başlıyorum.
Sık Sorulan Sorular
Bayat index'in çözümü refresh_interval'ı düşürmek mi?
Hayır. refresh_interval yalnızca zaten index'lenmiş dokümanların ne zaman aranabilir olacağını belirler—saniyeler, günler değil. Index kaynak kayıtları kaçırıyor ya da yanlış yansıtıyorsa sorun sync pipeline'ındadır; hiçbir refresh ayarı bunu düzeltmez.
Kaynakta silinen kayıtların dokümanlarını nasıl temizlerim?
Ya yokluğu tespit edin—full pass'lerde last_synced damgalayıp dokunulmayanları _delete_by_query ile silin—ya da problemi baştan dolanın: yeni index'e reindex edip alias'ı çevirin. Crawl verisinde alias swap'ı tercih edin.
Index-per-tenant iyi bir multi-tenancy modeli mi?
Az tenant'la evet: izolasyon, tenant'a özel mapping, zahmetsiz offboarding. Tenant sayısı shard sayısını binlere sürüklediğinde ölçeklenmez. Tenant başına alias iki kapıyı da açık tutar.
Bir yıldan eski sonuçları nasıl elerim?
bool.filter içinde tazelik alanınıza range filter: { "range": { "updated_at": { "gte": "now-1y/d" } } }. Eski sonuçlar yok olmak yerine aşağı sıralansın istiyorsanız decay function kullanın.