Araç telemetrisi tahtada kolay görünür: cihazlar JSON gönderir, index'lersin, dashboard çizersin. Sonra gerçek hayat başlar. Cihazlar sana "son 5 dakikada gidilen mesafe"yi göndermez; kümülatif counter gönderir. Event'in içinde sürücü adı yoktur, sadece driverId vardır. Ve veri hiç durmaz—altı ay sonra kimsenin sorgulamadığı dokümanlar için hot-tier parası ödersin.
Bunu bir araç takip platformu için (otobüsler, garajlar, tek cluster üzerinde onlarca filo müşterisi) Elasticsearch üzerinde uçtan uca kurdum. Bu rehber o işin damıtılmış hali: event'ler arasındaki farkı transform ve ingest pipeline ile hesaplamak, enrich processor'ı lookup table olarak kullanmak ve rollover + ILM ile zaman serisini ucuza tutmak. Tüm örnekler gerçek production çalışmasından genelleştirildi—uydurma rakam yok.
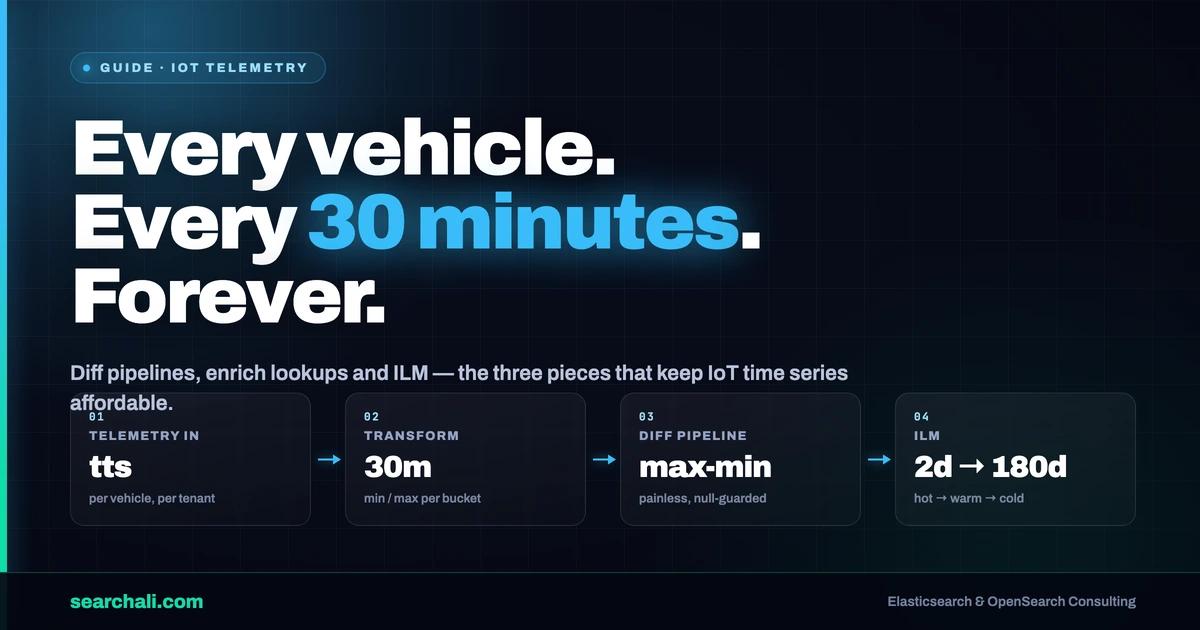
Kısa cevap: Delta'ları sorgu anında hesaplamayın. Event'leri araç başına zaman bucket'larına bölen, her counter'ın min/max değerini üreten bir continuous transform çalıştırın; transform'un destination index'ine bir diff ingest pipeline bağlayın (ctx.field.diff = max - min). Referans verileri (sürücü, vardiya, araç tipi) enrich policy'lerle, index'in default_pipeline ayarı üzerinden otomatik ekleyin. Ham event'leri hot-warm-cold mimaride rollover + ILM ile yönetin; her stream için bir write alias, bir search alias kullanın.
Verinin şekli: delta değil, counter
Filo gateway'inden gelen tipik bir event (kısaltılmış):
{
  "customerid": 2502,
  "vehicle": 3052,
  "category": "FMS",
  "tts": 1647613643,
  "CTD": 128403.5,
  "CTF": 20441.2,
  "dateandtime": "2022-03-18T14:27:23.000Z"
}
CTD toplam mesafe, CTF toplam yakıt; event başına bunun gibi ~30 kümülatif counter vardı. Herkesin istediği KPI'lar—araç başına yarım saatte gidilen km, tüketilen yakıt, harcanan enerji—hepsi bir pencere üzerinde max(counter) - min(counter). Bunu her dashboard yenilemesinde aggregation ile yapmak hem yavaş hem israf. Biz de materialize ettik.
Adım 1: Event'leri pencerelere çeviren continuous transform
Mantığı önce POST _sql/translate ile prototipledik (SELECT min(...), max(...) GROUP BY bir pivot tasarlamanın en hızlı yolu), sonra kalıcı hale getirdik:
PUT _transform/vehicle_kpi_transform
{
  "source": { "index": ["vehicle-events-*"] },
  "pivot": {
    "group_by": {
      "tts": { "histogram": { "field": "tts", "interval": "1800" } },
      "customerid": { "terms": { "field": "customerid" } },
      "vehicle": { "terms": { "field": "vehicle" } }
    },
    "aggregations": {
      "CTD.max": { "max": { "field": "CTD" } },
      "CTD.min": { "min": { "field": "CTD" } },
      "minDate": { "min": { "field": "dateandtime" } },
      "maxDate": { "max": { "field": "dateandtime" } }
    }
  },
  "frequency": "60m",
  "sync": { "time": { "field": "dateandtime" } },
  "dest": { "index": "vehicle_kpi", "pipeline": "diff_calculation_pipeline" }
}
Production'da group_by içinde sürücü adı, vardiya adı ve araç tipi de vardı; aggregation'lar tüm counter'ları kapsıyordu. Transform 30 dakikalık (1800 saniye) bucket'lar üzerinde saatte bir çalıştı; cluster'a baskı yapmasın diye bulk size 500 seçildi.
Adım 2: Diff hesaplayan ingest pipeline
İşin sırrı dest.pipeline: transform'un yazdığı her doküman, delta'ları hesaplayan bir ingest pipeline'dan geçer.
PUT _ingest/pipeline/diff_calculation_pipeline
{
  "processors": [
    {
      "script": {
        "lang": "painless",
        "source": """
          if (ctx.CTD.max != null && ctx.CTD.min != null) {
            ctx['CTD']['diff'] = ctx.CTD.max - ctx.CTD.min;
          }
        """,
        "ignore_failure": true
      }
    },
    {
      "script": {
        "lang": "painless",
        "source": """
          if (ctx.maxDate != null && ctx.minDate != null) {
            ctx['datetimediff'] = ChronoUnit.MILLIS.between(
              ZonedDateTime.parse(ctx['minDate']),
              ZonedDateTime.parse(ctx['maxDate'])) / 1000;
          }
        """,
        "ignore_failure": true
      }
    }
  ]
}
Bu pipeline'ı production'da v1 → v3 arası itere ederken üç ders çıktı:
- Her şeyi guard'layın. İlk sürüm, alanın olmadığı veya boş geldiği dokümanlarda kırıldı. Null kontrolleri + processor başına
ignore_failure: true, tek bozuk counter'ın tüm dokümanı öldürmesini engelledi. - Sıfır gürültüsünü temizleyin. v3'e,
count/min/max/avg/diffdeğerlerinden biri0olduğunda counter objesini komple silenremoveprocessor'lar eklendi—dashboard'lar gözle görülür temizlendi. - Elle yazmayın, üretin. ~30 counter için processor listesini küçük bir shell for-loop +
sedile alan listesinden ürettik. Tek şablon, otuz processor, sıfır typo.
Aynı iş için rollup'ları da denedik ve duvara tosladık: _rollup_search exists query'yi reddetti, value_count metrikleri "unable to unroll" hatası verdi, Kibana search bar rollup index'lerini hiç filtreleyemedi. Kazanan transform oldu. (Elastic rollup'ları deprecate etti; transforms kullanın.)
Adım 3: Lookup table olarak enrich processor
Event'lerde vehicle ve driverId var, okunabilir isim yok. Enrich policy, Elasticsearch içinde bir lookup table'dır:
PUT /_enrich/policy/driver-policy
{
  "match": {
    "indices": "driver_lookup",
    "match_field": "vehicle",
    "enrich_fields": ["driverId", "location"]
  }
}
POST /_enrich/policy/driver-policy/_execute
Sonra bir ingest pipeline bunu uygular; index'in default_pipeline ayarı sayesinde her yeni doküman için otomatik çalışır:
PUT /_ingest/pipeline/driver_lookup
{
  "processors": [
    { "enrich": { "policy_name": "driver-policy", "field": "vehicle",
                  "target_field": "tmp", "max_matches": 1 } },
    { "rename": { "field": "tmp.driverId", "target_field": "driverId" } },
    { "remove": { "field": "tmp" } }
  ]
}
PUT vehicle-events/_settings
{ "index.default_pipeline": "driver_lookup" }
Production pipeline'ı üç lookup'ı zincirledi: driver id'den sürücü adı, shiftId'den vardiya adı ve set processor ile üretilen composite key'den ("{{customerid}}_{{vehicle}}") araç tipi. Pratik notlar: her enrich/rename adımına ignore_missing + ignore_failure koyun; lookup kaynağı değişince _execute'u tekrar çalıştırın (.enrich-* index'i snapshot'tır, canlı join değildir); ve bir pipeline referans verdiği sürece policy silinemez—Elasticsearch "a pipeline is referencing it" diye reddeder.
Adım 4: Hot-warm-cold üzerinde rollover + ILM
Telemetri durmaz; index lifecycle opsiyonel değildir. Tenant başına kurduğumuz desen:
- Index template, pattern'i lifecycle'a bağlar:
index.lifecycle.name+index.lifecycle.rollover_alias, artıdefault_pipeline. - İlk index (
...-000001) write alias'ı taşıyacak şekilde elle oluşturulur. - Stream başına iki alias: index'leme için rollover alias, okuma için search alias (multi-tenant sorgular için
customeridüzerinden filtered alias—tek template'te 24 tane çalıştırdık).
Sorgular güncel veriye yoğunlaştığı için production policy agresifti: hot 2 günlük max age ile rollover, rollover sonrası hemen warm'a, 180. günde cold'a geçiş; silme fazı yok, veri cold'da kalıyor. Elastic Cloud üzerinde (v8.1.1) bu, iki zone'a yayılmış 2 hot + 2 warm + 2 cold data node ve 3 master ile döndü—toplam 2.46 TB depolama, saatte yaklaşık $2.27; çünkü byte'ların çoğu pahalı hot NVMe yerine ucuz warm/cold donanımda oturuyordu.
Saat kazandıran iki test ipucu: policy doğrularken indices.lifecycle.poll_interval'ı varsayılan 10m'den 15s'e indirin; herhangi bir rollover eşiğine güvenmeden önce shard boyutlarını 10–50 GB best-practice bandına oturtun. Mekaniklerin tamamı Elastic'in ILM dokümantasyonunda.
Öğrendiklerimiz
- Delta'ları materialize edin. Continuous transform → destination pipeline →
max - min. Sorgu anında matematik filo ölçeğinde yürümez. - Her painless script'e null guard, her processor'a
ignore_failurekoyun; cihaz verisinde eksik counter her zaman olacak. - Enrich = lookup table.
index.default_pipelineüzerinden bağlayın; referans veri değişince policy'yi yeniden execute edin. - Stream başına iki alias—rollover alias ile yazın, search/filtered alias ile okuyun. Multi-tenant filoyu yönetilebilir kılan budur.
- ILM veriyi hızlı taşısın. Hot ay değil gün mertebesinde; tarihçeyi cold tier çok daha ucuza tutar.
- Tekrarlı processor'ları script ile üretin. Elle düzenlenmiş otuz painless bloğu, otuz typo ihtimalidir.
Sık Sorulan Sorular
Elasticsearch'te iki event arasındaki farkı nasıl hesaplarım?
Ad-hoc sorgular için min/max aggregation + bucket_script kullanın (kaynak-hedef seyahat süresini tam olarak böyle, geo_distance filtreleriyle hesapladık). Dashboard'ların sürekli okuduğu her şey içinse min/max aggregation'lı bir continuous transform kurup max - min işlemini destination index'in ingest pipeline'ında yapın.
Lookup verisi değişince enrich processor dokümanları günceller mi?
Hayır. Enrich, policy'yi _execute ettiğinizde oluşan sistem .enrich-* index'inden okur. Yeni dokümanlar son execution'daki değerleri alır; index'lenmiş dokümanlar değişmez. Lookup table'ınız hareketliyse policy'yi periyodik yeniden execute edin; geçmişi doldurmak için _update_by_query kullanın.
IoT telemetrisi için rollup mı transform mu?
Transform. Testlerimizde rollup search exists query'yi reddetti, value_count metriklerini unroll edemedi ve Kibana rollup index'lerini search bar'dan filtreleyemedi. Rollup'lar deprecated; transform'larda bu sınırlar yok ve destination pipeline desteği var.
Telemetri hot tier'da ne kadar kalmalı?
Ingest-ağırlıklı, güncel-veri sorgularınızın ihtiyacı kadar. Bizim production policy 2 günde rollover yapıp veriyi hemen warm'a taşıdı—hot donanım depolama için değil, indexing hızı içindir. Kendi sorgu pattern'inizle doğrulayın, taşımayı ILM'e bırakın.
Telemetri cluster'ınıza ikinci bir göz isterseniz—transform, enrich tasarımı veya lifecycle maliyeti—searchali.com'daki Elasticsearch monitoring ve health check yaklaşımıma göz atın.