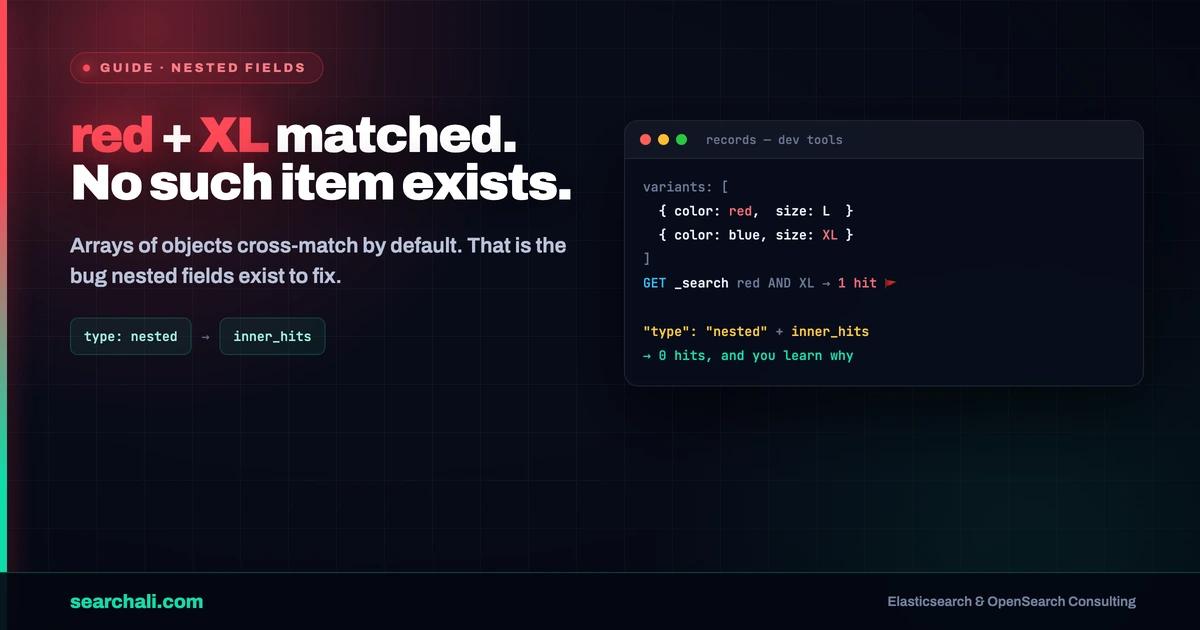
Birkaç haftada bir aynı bug önüme geliyor: eşleşmemesi gereken dokümanları döndüren bir query ya da toplamaması gereken değerleri toplayan bir aggregation. On vakadan dokuzunda sebep aynı—veri modeli nested derken mapping object diyor, ya da mapping nested ama aggregation nested bloğundan geçmiyor.
Bu rehber, her seferinde link atmak istediğim versiyon. Tek bir çalıştırılabilir veri seti, nested-vs-object tuzağı, çalışan bir nested aggregation, hangi elemanın eşleştiğini gösteren inner_hits ve bunların faturası. Snippet'leri Kibana Dev Tools'a yapıştırıp çalıştırabilirsiniz.
Kısa cevap: Elasticsearch, object array'lerini varsayılan olarak düzleştirir; farklı elemanların alan değerleri birbirine karışır ve query'ler çapraz eşleşir. nested tipi her elemanı gizli bir alt doküman olarak indeksler ve alanları bir arada tutar—ama bu sefer her query ve aggregation doğru path ile nested bloğundan geçmek zorundadır; hangi elemanın eşleştiğini de inner_hits gösterir. Bedeli: her nested eleman ekstra bir Lucene dokümanıdır; index boyutu, indexleme süresi ve update maliyeti array uzunluğuyla büyür.
Nested vs object: çapraz eşleşme tuzağı
Varsayılan object mapping array'leri düzleştirir. Şu doküman:
PUT products/_doc/1
{
  "name": "hoodie",
  "variants": [
    { "color": "red",  "size": "s",  "stock": 4 },
    { "color": "blue", "size": "xl", "stock": 0 }
  ]
}
içeride variants.color: ["red", "blue"] ve variants.size: ["s", "xl"] olarak indekslenir. red ile s arasındaki bağ kaybolur. Bu yüzden aşağıdaki query, kırmızı XL varyant hiç olmadığı halde eşleşir:
GET products/_search
{
  "query": {
    "bool": {
      "must": [
        { "term": { "variants.color": "red" } },
        { "term": { "variants.size": "xl" } }
      ]
    }
  }
}
nested tipinin var olma sebebi tam olarak bu. Nested mapping ile her varyant kendi gizli dokümanı olur ve red + xl kombinasyonu doğru şekilde hiçbir şey döndürmez:
PUT products
{
  "mappings": {
    "properties": {
      "name": { "type": "text" },
      "variants": {
        "type": "nested",
        "properties": {
          "color": { "type": "keyword" },
          "size":  { "type": "keyword" },
          "stock": { "type": "integer" }
        }
      }
    }
  }
}
Pratik kural: elemanların alanlarını hiçbir zaman kombinasyon halinde sorgulamıyorsanız (ya da array hep tek elemanlıysa) object yeterli ve daha ucuz. "Aynı varyantın rengi VE bedeni" sorusu masaya geldiği an nested şart. Tip referansı için Elastic'in nested field dokümantasyonuna bakın.
Nested aggregation: önce path'e gir
Aggregation'lar, siz açıkça nested aggregation ile içeri girmedikçe nested alt dokümanları görmez. Bu rehberin tohumu olan ham örnek de tam bu pattern: nested records alanı olan bir index ve yalnızca filtreyle eşleşen elemanlar üzerinde sum:
PUT records
{
  "mappings": {
    "properties": {
      "records": {
        "type": "nested",
        "properties": {
          "data":  { "type": "keyword" },
          "value": { "type": "integer" }
        }
      }
    }
  }
}

POST records/_doc
{
  "records": [
    { "data": "test1", "value": 1 },
    { "data": "test2", "value": 2 }
  ]
}

GET records/_search
{
  "size": 0,
  "aggs": {
    "all_records": {
      "nested": { "path": "records" },
      "aggs": {
        "only_test2": {
          "filter": { "term": { "records.data": "test2" } },
          "aggs": {
            "total_value": { "sum": { "field": "records.value" } }
          }
        }
      }
    }
  }
}
Response'un şekli:
{
  "aggregations": {
    "all_records": {
      "doc_count": 2,
      "only_test2": {
        "doc_count": 1,
        "total_value": { "value": 2.0 }
      }
    }
  }
}
Burada iki nokta insanları düşürüyor. Birincisi, all_records.doc_count 2—nested aggregation parent dokümanları değil, nested elemanları sayar. İki elemanlı tek parent, iki doc raporlar. İkincisi, sum'ı yalnızca eşleşen elemanlara daraltan şey filter alt aggregation'ıdır; filtreyi query tarafına koyarsanız nested agg yine eşleşen her parent'ın tüm elemanlarını gezer ve test1 değerleri toplamınıza sızar. Eleman bazlı matematik istiyorsanız filtre nested scope'un içinde durmalı. Sonrasında parent seviyesine dönmek için reverse_nested kullanılır.
inner_hits: hangi eleman eşleşti?
nested query parent dokümanın tamamını döndürür. API'yi tüketen taraf hemen sorar: "iyi de hangi varyant eşleşti?" Cevap inner_hits:
GET products/_search
{
  "query": {
    "nested": {
      "path": "variants",
      "query": {
        "bool": {
          "must": [
            { "term": { "variants.color": "red" } },
            { "range": { "variants.stock": { "gt": 0 } } }
          ]
        }
      },
      "inner_hits": {
        "size": 3,
        "_source": ["variants.color", "variants.size", "variants.stock"]
      }
    }
  }
}
Artık her hit, eşleşen elemanları array offset'iyle birlikte taşır:
{
  "hits": {
    "hits": [
      {
        "_id": "1",
        "_source": { "name": "hoodie", "variants": [ "..." ] },
        "inner_hits": {
          "variants": {
            "hits": {
              "total": { "value": 1, "relation": "eq" },
              "hits": [
                {
                  "_nested": { "field": "variants", "offset": 0 },
                  "_source": { "color": "red", "size": "s", "stock": 4 }
                }
              ]
            }
          }
        }
      }
    ]
  }
}
_nested.offset elemanın orijinal array'deki konumunu söyler—UI'da doğru satırı vurgulamak için birebir. Boyut notu: inner_hits.size varsayılanı 3'tür ve her inner hit, parent hit başına fetch edilir; 50 parent'lık bir sayfada size: 100 inner hit, hissedeceğiniz bir fetch amplifikasyonudur. Detaylar Elastic'in inner_hits dokümantasyonunda.
Nested'ın bedeli
Burada hiçbir şey bedava değil. İmzalamadan önce faturayı bilin:
- Gizli dokümanlar. 100 nested elemanlı bir parent, 101 Lucene dokümanıdır. Index boyutu ve segment merge yükü doküman sayısıyla değil eleman sayısıyla ölçeklenir.
- Update her şeyi yeniden yazar. Nested alt dokümanlar bağımsız güncellenemez; tek bir elemanı değiştirmek parent'ı ve tüm elemanlarını yeniden indeksler.
- Limitler boşuna yok. Varsayılanlar:
index.mapping.nested_fields.limitindex başına 50 nested alan,index.mapping.nested_objects.limitdoküman başına 10.000 nested eleman. Bu limitleri yükseltiyorsanız veri modeliniz ayrı dokümanlara bölünmek istiyor demektir. - Query yükü. Nested query ve
inner_hitsquery zamanında join benzeri iş yapar; geniş array'lerde bu, search latency ve fetch süresinde görünür.
Maliyet ısırdığında alternatifler: her elemanı kendi dokümanına denormalize etmek (yüksek kardinaliteli array'lerde benim varsayılanım), eleman bazlı kombinasyon gerekmiyorsa flattened tipi, child'ların bağımsız update'i şartsa—kendi query maliyetini kabul ederek—join field. Nested ağırlıklı query'ler zaten production'daysa, latency'yi kullanıcıdan önce siz görün: searchali.com monitoring tam bunun için var.
Sık Sorulan Sorular
Object yerine nested'ı ne zaman kullanmalıyım?
Yalnızca aynı array elemanının birden fazla alanını kombinasyon halinde sorguluyorsanız (color = red VE size = xl, aynı varyantta). Elemanlar bağımsız sorgulanıyorsa ya da array tek objeliyse varsayılan object mapping'de kalın—indexlemesi, update'i ve query'si daha ucuz.
Nested alandaki aggregation neden doc_count 0 dönüyor?
Çünkü aggregation nested scope'a hiç girmedi. Üst seviyede doğrudan variants.color üzerinde terms, sum veya avg hiçbir şey görmez; önce "path": "variants" ile bir nested aggregation'a sarın. Query'lerde de kural aynı: nested alana düz term query sessizce hiçbir şeyle eşleşmez.
inner_hits query'yi yavaşlatır mı?
Evet, makul ölçüde—eşleşen alt dokümanlar için parent başına ek bir fetch fazı ekler. inner_hits.size'ı küçük tutun (varsayılan 3), _source'u gösterdiğiniz alanlara indirin ve eşleşen elemanı hiç göstermediğiniz query'lerde kullanmayın.
Sonuçları nested bir alana göre sıralayabilir miyim?
Evet. sort içinde nested bloğu (path ve isteğe bağlı filter) ile min/max gibi bir mode kullanın; parent'ı hangi elemanın değerinin temsil edeceğini bu belirler. Sort'ta nested bloğu olmadan Elasticsearch hangi alt dokümanı okuyacağını çözemez.
Öğrendiklerimiz
- Varsayılan
objectmapping array'leri düzleştirir—çapraz eleman eşleşmesi query bug'ı değil, mapping bug'ıdır. - Nested alanlardaki aggregation'lar doğru
pathilenestedagg ister; yoksa sonuç ya sıfırdır ya çöptür. - Eleman seviyesi filtreleri nested aggregation scope'unun içine koyun; yoksa eşleşmeyen elemanların değerleri hesaba sızar.
- "Hangi eleman eşleşti" sorusunun cevabı
inner_hits(ve_nested.offset)—sizeve_source'u dar tutun. - Her nested eleman gizli bir Lucene dokümanıdır: 100 varyant = 101 doküman; tek eleman update'i hepsini yeniden indeksler.
- Varsayılan limitler: index başına 50 nested field, doküman başına 10.000 nested object—bu limitlere çarpmak veri modeli sorunudur.
Yavaşlayan ya da tuhaf davranan bir Elasticsearch cluster'ı ile mi uğraşıyorsunuz? searchali.com üzerinden ulaşın.