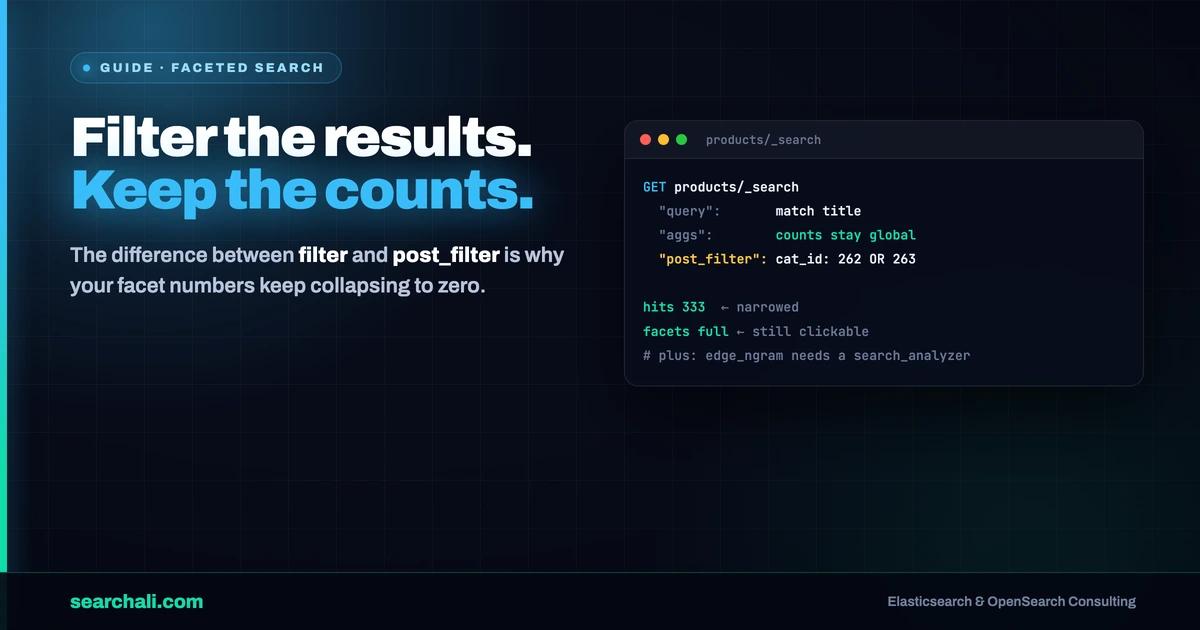
Kullanıcı mağazanızda iki kategori kutusunu işaretliyor. Ürün listesi daralıyor—güzel. Ama aynı anda kenar çubuğundaki diğer tüm facet'ler yalnızca filtreden sağ çıkan seçeneklere düşüyor; kullanıcı artık başka ne olduğunu göremiyor. Faceted search'ün klasik hatası budur ve sebebi filtreyi yanlış yere koymaktır.
Bu hatayla, ABD merkezli bir medikal malzeme e-ticaret platformunun aramasını kurarken birebir karşılaştım (isim anonim; iş ajansları üzerinden geldi). Katalog Postgres'te, Logstash ile Elasticsearch'e senkron, önde Laravel bir storefront. Çözüm, her e-ticaret aramasının ihtiyaç duyduğu pattern: post_filter + cross-filtered aggregation. İşte gerçek sorgularla.
Kısa cevap: query içindeki filtre aggregation'lardan önce çalışır; facet sayıları her tıklamada küçülür. post_filter aggregation'lardan sonra çalışır ve yalnızca hit listesini daraltır; facet'ler global sayılarını korur. Çoklu facet UX'i için her facet'e, diğer facet'lerin seçimlerini taşıyan birer filter sub-aggregation ekleyin. Aynı istek, üç konum, üç farklı görev.
Filtrenin yeri facet sayılarını belirler
Tek bir arama isteği aynı anda iki iş yapar: hit döndürmek ve kenar çubuğunu hesaplamak. Elasticsearch filtre için üç yer sunar; her biri kullanıcının gördüğünü değiştirir:
queryiçinde — hem hit'leri hem aggregation'ları etkiler. Her zaman geçerli kısıtlar için (ör.is_active: true).- Aggregation içinde (
filteragg) — yalnızca o aggregation'ı etkiler. Bir facet'i diğer facet'lerin seçimleriyle çapraz filtrelemek için. post_filteriçinde — aggregation'lar çalıştıktan sonra yalnızca hit listesini etkiler. Kullanıcının kendi facet seçimleri için.
Elastic dokümantasyonu post_filter'ı tam olarak bu senaryo için anlatır: filter search results.
Pattern: global aggs, cross-filtered aggs, post_filter
Canlıya aldığımız yapı bu (index ve alan adları genelleştirildi, yapı çalışan istekten birebir). Kullanıcı yedi kategori kutusu işaretlemiş durumda:
GET products/_search
{
  "query": {
    "bool": {
      "should": [
        { "match": { "title": { "query": "oximeter", "minimum_should_match": "75%" } } },
        { "match": { "title.standard": { "query": "oximeter", "fuzziness": "AUTO", "minimum_should_match": "100%" } } },
        { "match_phrase": { "title.standard": { "query": "oximeter" } } }
      ]
    }
  },
  "size": 12,
  "aggs": {
    "categories": {
      "terms": { "field": "categories.cat_label.keyword", "size": 1000 },
      "aggs": {
        "cat_id": { "terms": { "field": "categories.cat_id", "size": 1000 } }
      }
    },
    "manufacturers": {
      "terms": { "field": "manufacturer.keyword", "size": 1000 }
    },
    "manufacturers_filtered": {
      "filter": {
        "bool": {
          "should": [
            { "term": { "categories.cat_id": "262" } },
            { "term": { "categories.cat_id": "263" } }
          ]
        }
      },
      "aggs": {
        "manufacturers": { "terms": { "field": "manufacturer.keyword", "size": 1000 } }
      }
    }
  },
  "post_filter": {
    "bool": {
      "must": {
        "bool": {
          "should": [
            { "term": { "categories.cat_id": "262" } },
            { "term": { "categories.cat_id": "263" } }
          ]
        }
      }
    }
  }
}
Buradan okunacak üç şey:
Kullanıcı seçimleri post_filter'da yaşar
Seçili cat_id değerleri post_filter içinde should altında term clause'ları olarak durur (kategoriler birbirinin OR'u). Hit'ler daralır; aggregation'lar daralmaz. Kategori facet'i tüm kategorileri tam sayılarıyla göstermeye devam eder; işareti kaldırıp keşfetmek mümkün kalır.
Her facet'in cross-filtered ikizi olur
manufacturers global. manufacturers_filtered aynı terms agg'i, kategori seçimlerini taşıyan bir filter agg içine sarar. UI, seçilen kategorilere saygılı üretici sayıları gösterir—kategori facet'inin genişliğini gizlemeden. Kural: bir facet, kendi seçimi hariç tüm seçimlerle filtrelenir.
Sort filtreli listede de çalışır
post_filter sort ile sorunsuz birleşir. Kullanıcı "Price low to high" seçtiğinde aynı istek post_filter'ın yanında "sort": [{ "pp_unit_price": { "order": "asc" } }] taşıdı. Yedi filtre uygulandığında storefront 333 sonuç gösterdi, sayfa başına 12 ürün.
Sahadan notlar: sağlık e-ticaret kataloğu
Katalog dokümanlarında title, item_description, manufacturer ve cat_id, cat_label, cat_full_name (> ile ayrılmış hiyerarşi yolu) taşıyan bir categories dizisi var. Tüm string alanlar dynamic_templates ile eşlendi: autocomplete analyzer'lı text + facet'ler için .keyword subfield. Autocomplete analyzer: standard tokenizer, lowercase, kstem ve 1–20 karakterlik edge_ngram filter.
Üstteki autocomplete _msearch kullandı: title üzerinde highlight'lı bir ürün sorgusu, artı ortalama skora göre sıralanmış top_hits'li bir manufacturer.keyword terms aggregation'ı—dropdown tek gidiş-dönüşte "items found" ve "manufacturers found" gösteriyor.
edge_ngram tuzağı: 0 olması gereken 1542 sonuç
Test sırasında anlamsız bir terim 1.542 sonuç döndürdü. Sebep: search_analyzer tanımlanmadığı için edge_ngram analyzer (min_gram: 1) arama anında da çalışıyordu. Sorgu 1–20 karakterlik gram'lara bölündü; tek harfli gram'lar kataloğun neredeyse tamamıyla eşleşti—fuzziness: AUTO durumu daha da kötüleştirdi. Çözüm standart: edge_ngram index-time analyzer olarak kalsın, autocomplete alanlarına "search_analyzer": "standard" ekleyin. Partial matching kullanıyorsanız ilk bakılacak yer burası.
Bir saha notu daha: geliştirme sırasında tarayıcının cluster'a doğrudan sorgu atabilmesi için Elasticsearch CORS ayarları (http.cors.enabled, allow-origin) açılmıştı. Prototip için tamam—canlıya böyle çıkmayın. Production trafiğini backend'iniz veya bir search proxy üzerinden geçirin; kimlik bilgileri ve cluster yüzeyi gizli kalsın.
Burada dönüşüm, latency veya ciro rakamı yok çünkü kaynak pakette yok—gözlemlenebilir sonuçlar düzelen match davranışı, yedi eşzamanlı filtre altında sabit kalan facet sayıları (333 sonuç) ve filtreli listede fiyat sıralamasıydı. Sorgularınızın production'da gerçekte ne yaptığını görmek isterseniz searchali.com/tr/monitoring tam bunun için var.
Öğrendiklerimiz
- Kullanıcının facet seçimleri
post_filter'a, aslaquery'ye değil—yoksa kenar çubuğu her tıklamada çöker. - Her facet'e, diğer facet'lerin seçimlerini taşıyan bir
filter-agg ikizi verin. Sayılar bağlama saygılı, genişlik kayıpsız kalır. edge_ngramkullanıyorsanızsearch_analyzertanımlayın. Index-time gram + query-time gram = çöp girdiye eşleşme.min_gram: 1agresiftir. Tek karakterli prefix şart değilse 2–3'ten başlayın.- Sort
post_filterile birleşir. Filtreli listede fiyat sıralaması sorguyu yeniden yapılandırmayı gerektirmez. - CORS'u açık cluster bir dev kısayoludur, mimari değildir. Yayına çıkmadan öne backend koyun.
Sık Sorulan Sorular
post_filter sorguyu yavaşlatır mı?
Biraz yavaşlatabilir: query ile eşleşip post_filter'ın elediği hit'ler yine skorlanır ve aggregation'lar filtre öncesi küme üzerinde çalışır—zaten amaç bu. Bu projede her zaman geçerli kısıtlar query'de kaldı, yalnızca facet seçimleri post_filter'a gitti; maliyet böyle kontrol altında kalıyor.
Neden iki ayrı sorgu değil—biri hit, biri facet?
Olur, _msearch ile (bu proje autocomplete için kullandı). Ama post_filter + filtered aggs'li tek istek, hit'lerle facet'leri aynı shard anlık görüntüsünden tutarlı tutar ve her filtre tıklamasında gidiş-dönüşü yarıya indirir.
Bir facet'i diğerlerine göre filtrelerken kendi seçeneklerini nasıl korurum?
Facet başına, diğer tüm facet'lerin seçimlerini içeren bir filter aggregation kurun; facet'in terms agg'i içine yuvalansın. Kategori facet'i üretici seçimleriyle filtrelenir, tersi de öyle—her biri kullanıcının mevcut bağlamında gezilebilir kalır.
Facet alanları keyword mü text mi olmalı?
Facet'ler exact değer üzerinde aggregate eder; keyword kullanın (burada manufacturer.keyword, categories.cat_label.keyword). Multi-field pattern—eşleşme için text, aggregation ve sort için .keyword subfield—tek kaynak alandan iki işi de görür.
Elasticsearch veya OpenSearch üzerinde faceted search mi kuruyorsunuz? Bu pattern'i production'da yayına aldım. → searchali.com