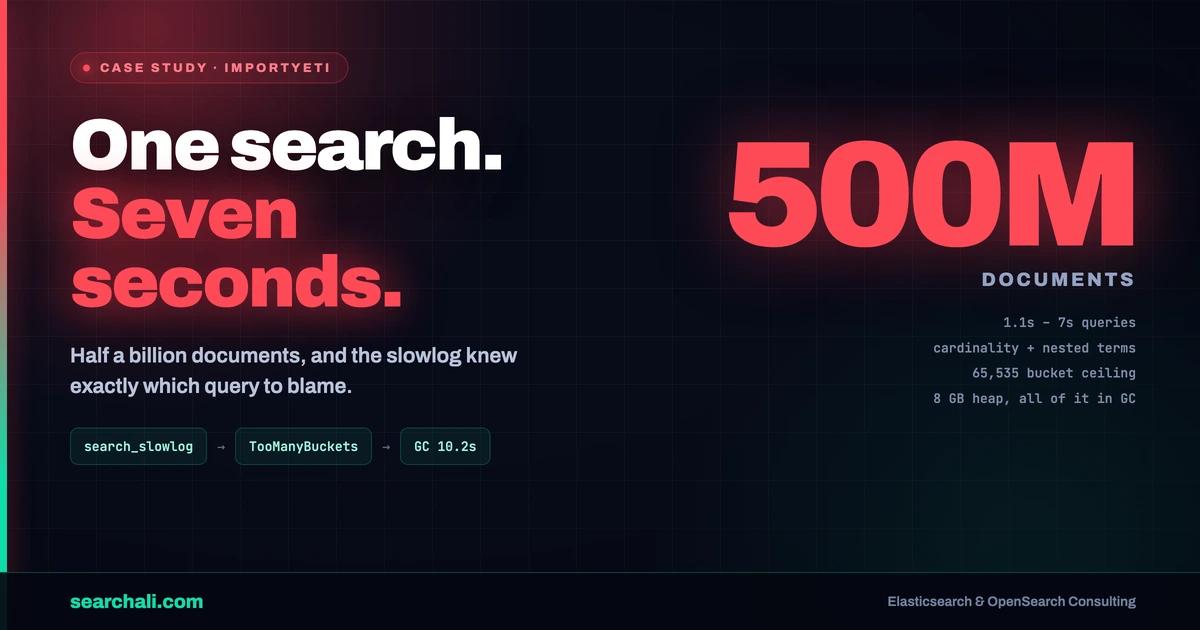
ImportYeti, yaklaşık 70 milyon ABD konşimentosunu (bill of lading) herkesin arayabildiği bir ürün: FOIA ile alınan kamuya açık gümrük verisi, tedarikçi arama motoruna dönüştürülmüş. Kaputun altında Amazon OpenSearch Service, 4 cluster'a dağılmış ~500 milyon doküman ve neredeyse her isteğin aggregation'a dönüştüğü bir arama sayfası var.
Benden istenen şey bir health check'ti; hedef netti: alınabilecek en iyi fiyat/performans oranına sahip cluster. Bildirilen darboğaz aggregation'lardı. Tahmin yürütmek yerine kanıt topladık: slowlog'lar, uygulama logları ve uygulamanın OpenSearch'e gönderdiği gerçek sorgular. İşte bulduklarımız—ve yalnızca kanıt paketinde var olan sayılar.
Kısa cevap: 1 saniyelik slowlog eşiği gerçek iş yükünü ortaya çıkardı: fuzziness'lı query_string aramaları, 5.3M+ hit'lik sonuç kümeleri üzerinde cardinality ve derin iç içe terms aggregation'ları; bazıları 7 saniyeye kadar sürüyordu. Uygulama logları üç somut bulgu ekledi: GC overhead (8 GB heap'te 10.2 saniyenin 10.2 saniyesi çöp toplamayla geçmiş), varsayılan 65.535 sınırında patlayan TooManyBucketsException ve uygulamanın query builder'ındaki bozuk escape karakterinden kaynaklanan parse hataları. Çözümler gösterişsiz ama etkiliydi: data node'ları dikey olarak 64 GB RAM'e doğru büyüt (memory-optimized r7i/r7g), en az 3 node tut, ~20 node altında dedicated coordinator kullanma, search.max_buckets'ı AWS support üzerinden yükselt ve query generator'ı uygulama tarafında düzelt.
Sorun
ImportYeti'nin ürünü aramanın kendisi. Kullanıcı "shoes" yazıyor; karşılığında 567.259 sevkiyat, 170.210 şirket ve 49.981 tedarikçi geliyor—her sekme konşimento index'i üzerindeki aggregation'larla besleniyor. "2.000'den fazla sevkiyatı olan tedarikçiler" gibi bir filtre 24 milyon sevkiyata dokunuyor. Bu, yavaş sorgunun bir dashboard'u geciktirdiği bir log cluster'ı değil; yavaş aggregation, ürünün kendisinin yavaşlaması demek.
Başlangıçtaki tablo:
- ~500 milyon doküman, 4 cluster, Amazon OpenSearch Service (engine 2.17)
r7g.largeüzerinde 6 data node—memory-optimized aile, ama ailenin küçük ucu- Ayda bir ingestion: veri, alias arkasındaki tarih son ekli index'lerde yeniden kuruluyor; batch yükleme sırasında
refresh_interval: -1 - Hedef: maksimum donanım değil, en iyi fiyat/performans
Baştan söylemekte fayda var: index tasarımı zaten iyiydi. dynamic: strict mapping'ler, kullanılmayan alanlar disabled, sadece gereken yerde multi-field (keyword / snowball / edge_ngram), port ve ülkeler için updateable synonym_graph filtreleri ve sıcak aggregation alanlarında eager_global_ordinals. Bu bir "mapping'i düzelt" projesi değildi. Baskı, sorgu yükü ve donanım zarfındaydı.
Teşhis
Hiçbir şeye dokunmadan önce slowlog'u oku
Ana BOL index'inde query ve fetch fazları için 1000ms slowlog eşiği zaten tanımlıydı. Teşhis işinin çoğunu bu tek ayar yaptı:
"search": {
  "slowlog": {
    "threshold": {
      "query": { "warn": "1000ms" },
      "fetch": { "warn": "1000ms" }
    }
  }
}
Slowlog tutarlı bir hikâye anlattı. Sorgular 1.1s ile 7s arasında sürüyordu ve yavaş olanlar aynı şekli paylaşıyordu:
arrival_daterange'iyle birliktefuzziness: AUTOvemax_determinized_states: 10000içerenquery_stringtotal_hits[5332728+ hits]olarak raporlanan sonuç kümeleri üzerinde,precision_threshold: 40000ilecompany_name.keywordalanındacardinalityaggregation- İç içe
termsaggregation'lar: 500 boyutunda tedarikçi terms agg'i, her bucket'ta altı ila sekiz sub-aggregation (en çok geçen ürünler, ağırlık toplamları, ülke, sevkiyat sayıları) - Sub-aggregation'a göre sıralanan (
weight desc) 403 boyutunda şirket terms agg'i—sub-agg sıralaması her shard'a ekstra iş yükler - Fetch fazında derin sayfalama:
from: 15000, size: 3000şeklinde sayfa yürüyüşleri
Uygulama logları üç bulgu ekledi
GC overhead. JvmGcMonitorService, JVM'in son 10.2s içinde 10.2s'yi çöp toplamayla geçirdiğini—yani node'un GC dışında hiçbir şey yapmadığını—raporladı; old gen 8 GB heap'te 1.9gb -> 1.9gb seviyesindeydi. r7g.large (16 GB RAM, ~8 GB heap) üzerinde bu iş yükü basitçe sığmıyor.
Bucket patlaması. Bir aggregation 65.536 bucket yaratmaya çalışıp varsayılan sınıra çarptı:
TooManyBucketsException: Trying to create too many buckets.
Must be less than or equal to: [65535] but was [65536].
This limit can be set by changing the [search.max_buckets] cluster level setting.
Managed OpenSearch Service'te bu ayarı kendiniz değiştiremezsiniz—kayıtlı workaround, AWS OpenSearch Service hata yönetimi dokümantasyonuna uygun şekilde search.max_buckets'ı 100k'ya çıkarmak için AWS support ticket'ı açmaktı.
Uygulamadan gelen bozuk sorgular. QueryShardException izleri Lucene ParseException: Lexical error ... Encountered: <EOF> gösteriyordu—üretilen query_string'in sonundaki hatalı escape edilmiş tırnak. Bu bir cluster sorunu değil, query-builder bug'ı; aksiyon uygulama tarafına gitti.
Çözüm
Dikey büyü, node sayısında dürüst kal
İlk toplantıdaki öneri log incelemesinden sonra da geçerliliğini korudu: 6 data node'lu bir cluster'da dedicated coordinator node erken bir yatırım—rehber ilke, ~20 node'a kadar beklemek ve bütçeyi data tier'a koymak. Boyutlandırma yönü: data node'lar 64 GB RAM'e ulaşana kadar dikey büyüme ve split-brain koruması için asla 3 node'un altına inmemek.
Memory-optimized adayları gerçek liste fiyatlarıyla karşılaştırdık (8 vCPU / 64 GiB r7g.2xlarge.search için on-demand $0.711/saat; 1 ve 3 yıllık reserved katmanları daha düşük) ve production domain'e hiçbir şey uygulamadan önce OpenSearch Service dry run analysis ile konfigürasyon değişikliklerini önizledik—r7i.xlarge.search / r7i.2xlarge.search üzerinde 3 data node, EBS GP3 depolama 450 GiB'den 900 GiB'ye doğru.
İş yükünün meşru olarak ihtiyaç duyduğu limitleri yükselt
Bucket limiti bir suistimal vakası değildi: ürün gerçekten geniş aggregate ediyor. Bu yüzden çözüm, sorguları eğip bükmek yerine search.max_buckets'ı AWS support üzerinden yükseltmekti. Aggregation maliyetinin kazara oluştuğu yerler—sub-agg sıralaması, gereğinden büyük terms boyutları, derin from sayfalaması—uygulama backlog'una gitti; OpenSearch'ün kendi performans dokümantasyonu da aynı yönü gösteriyor: search_after ile sayfala, bucket sayısını bilinçli tut.
Zaten çalışanı koru
refresh_interval: -1 ile aylık batch ingestion, alias'la değiştirilen tarih son ekli index'ler, strict mapping'ler ve aggregation alanlarındaki eager global ordinals olduğu gibi kaldı. Health check aynı zamanda neye dokunmayacağını bilmektir. Bu, sürekli cluster görünürlüğünün arkasındaki felsefeyle aynı—searchali monitoring'i bu yüzden geliştirdik: slowlog ve GC sinyalleri oradaydı; birinin onları okuması gerekiyordu.
Sonuçlar
Yalnızca kanıta dayalı. Bu çalışmanın çıktısı teşhis ile boyutlandırma/ayar yönüydü—kaynak pakette öncesi/sonrası latency yüzdeleri yok ve uydurmayacağım.
| Bulgu / aksiyon | Kanıt |
|---|---|
| Yavaş sorgular tespit edildi: 1.1s–7s, aggregation ağırlıklı | Search slowlog çıktıları, 1000ms WARN eşiği |
| 8 GB heap'li node'larda GC overhead doğrulandı | [gc] overhead, spent [10.2s] collecting in the last [10.2s] |
| Varsayılan 65.535 bucket limitine çarpıldı | TooManyBucketsException; 100k için AWS ticket yolu |
| Uygulama tarafındaki sorgu bug'ı izole edildi | Escape edilmiş tırnakta Lucene ParseException EOF |
| Boyutlandırma yönü: 64 GB RAM data node, ≥3 node, <20 node'da dedicated coordinator yok | Toplantı + inceleme notları |
| Konfigürasyon değişiklikleri güvenle önizlendi | OpenSearch Service dry run analysis (r7i ailesi, GP3 450→900 GiB) |
Öğrendiklerimiz
- Donanım satın almadan önce search slowlog'u aç. 1 saniyelik WARN eşiği, "aggregation'lar yavaş" cümlesini beş adet isimlendirilmiş sorgu şekline dönüştürdü.
- GC'nin 10.2 saniyenin 10.2 saniyesini harcaması, heap'in küçük olduğu anlamına gelir; nokta. Memory-optimized instance'larda node eklemeden önce 64 GB RAM'e doğru dikey büyü.
- 6 node'lu cluster'a dedicated coordinator ekleme. ~20 node altında o bütçe data tier'da daha çok iş yapar.
search.max_bucketsbir cluster ayarıdır—managed OpenSearch'te ise bir support ticket'ıdır. İş yükü meşru şekilde geniş aggregate ediyorsa limiti yükselt; etmiyorsa sorguyu düzelt.- Bazı "cluster sorunları" uygulama bug'ıdır. Query builder'daki tek bir bozuk escape karakteri, sunucu loglarında parse exception seli üretti.
- Managed domain'lerde dry run analysis kullan. Instance ve depolama değişikliklerinin blue/green etkisini, production arama ürününü onlara emanet etmeden önce önizle.
Aggregation ağırlıklı bir OpenSearch ürünü işletiyor ve zamanın nereye gittiğinden emin değil misiniz? → searchali.com