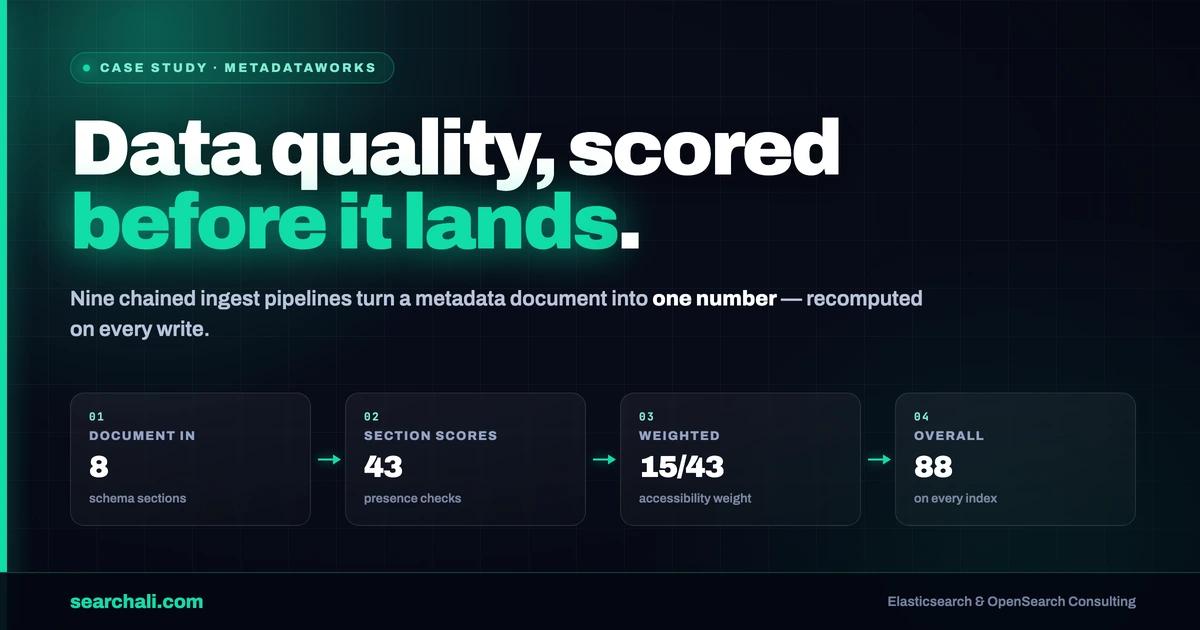
MetadataWorks, sağlık verileri için metadata katalogları geliştiren bir Birleşik Krallık şirketi. Dataset dokümanları HDR UK tanımlayıcı şemasını (hdruk@2.0.0) takip ediyor: summary, documentation, coverage, provenance, accessibility, enrichment & linkage, observation, structural metadata. Şema zengin; sahadaki gerçek ise şu: dataset'lerin çoğu alanların yarısı boş şekilde geliyor.
Talep basitti ama yanlış kurması kolaydı: her dataset'e metadata bütünlüğünü (completeness) yansıtan bir kalite skoru ver, her güncellemede skoru taze tut, publisher ve organizasyon bazında Kibana'da incelenebilir yap. Dışarıda batch job yok, uygulama tarafında skor kodu yok. Bunu yalnızca Elasticsearch ingest pipeline'ları ile nasıl yaptığımızı anlatıyorum.
Kısa cevap: Pipeline içinde pipeline mimarisi kurduk: şemanın her bölümü için bir ingest pipeline (toplam 8), Painless containsKey kontrolleriyle sub-level ve high-level completeness skorlarını hesaplıyor; son pipeline bunları ağırlıklı bir overall_score'a çeviriyor (ağırlıklar bölümlerin alan sayısıyla orantılı, toplam 43). Dokümanlar ?pipeline=main-pipeline ile indexlendiği için skor her index ve update işleminde yeniden hesaplanıyor. Kibana Lens de publisher ve organizasyon üyeliği bazında ortalama kaliteyi çiziyor.
Sorun
Çalışma toplantılarındaki gereksinim netti: "quality score per document üreten bir ingest pipeline kur; her update/indexing işleminde skor yeniden hesaplansın." Skor modeli üç seviyeliydi:
- Sub-level skor — örn.
summary.publisher,accessibility.usage - High-level skor — bölüm başına:
summary,documentation,accessibility, ... - Overall skor — doküman başına tek sayı
Üzerinde anlaşılan alan listesi 8 bölümü ve alt gruplarını kapsıyordu — summary.title'dan accessibility.formatAndStandards.formats'a kadar. Veride bulunan bazı alanlar (summary.publicationDate, dahili origin bloğu) bilinçli olarak skor dışı bırakıldı.
Skorlamadan önce bir ilk milestone da vardı: mevcut bir Tableau görselini Kibana'da yeniden üretmek. Orada klasik duvara çarptık — keyword sub-field'ı olmayan bir alan terms aggregation'da kullanılamaz; mapping düzelene kadar dashboard kurulamadı. Her zamanki gibi, analitikten önce mapping hijyeni.
Validity skoru (değer sadece var mı değil, doğru mu) konuşuldu ama sonraki faza bırakıldı. Yayına çıkan şey bir completeness skoru — notlar bu ayrımı dürüstçe kayıt altında tutuyor.
Teşhis
Türetilmiş bir skor nerede yaşamalı? Üç seçenek: uygulamada hesapla, query anında hesapla, ingest anında hesapla. Uygulama tarafı demek, yazan her servisin aynı mantığı tekrar kodlaması demek. Query anı (runtime field, scripted agg) her dashboard yenilemesinde CPU yakar. Ingest anı ise maliyeti yazma başına bir kez öder ve skoru sıradan bir indexed field'a çevirir: aggregate edilir, sıralanır, filtrelenir.
Fikri önce minik, jenerik bir pipeline ile prototipledik — konfigüre edilen fieldNames listesinden dokümanda kaç alan bulunduğunu sayıp existing_fields yazan bir Painless script. Desen doğrulanınca tam HDR UK alan listesine ölçekledik.
Tartışmaya değer tek tasarım kararı şuydu: 8 bölüm skorunun düz ortalaması, tek alanlık observation bölümünü 15 alanlık accessibility ile aynı ağırlıkta sayardı. Bu yüzden overall skor, ağırlıkları bölümlerin skorlanan alan sayısına eşit olan ağırlıklı ortalama oldu.
Çözüm
Şemanın her bölümüne bir ingest pipeline
Her bölüm, tek script processor ve bir remove temizlik adımından oluşan kendi pipeline'ını aldı. Summary, kısaltılmış hali:
PUT _ingest/pipeline/summary-score-pipeline
{
  "processors": [
    {
      "script": {
        "lang": "painless",
        "source": """
          Map summaryScore = new HashMap();
          int countSummarySub = 0;
          int countSummaryPublisher = 0;
          if (ctx.containsKey("summary")) {
            if (ctx.summary.containsKey("title")) { countSummarySub++; }
            if (ctx.summary.containsKey("abstract")) { countSummarySub++; }
            // ... contactPoint, keywords, publisher.name, publisher.contactPoint, publisher.memberOf
          }
          summaryScore.summary = ((countSummarySub + countSummaryPublisher) * 100) / params.totalFieldsSummary;
          summaryScore.sub = countSummarySub * 100 / params.totalFieldsSummarySub;
          summaryScore.publisher = countSummaryPublisher * 100 / params.totalFieldsSummaryPublisher;
          ctx.score_summary = summaryScore;
        """,
        "params": { "totalFieldsSummary": 7, "totalFieldsSummarySub": 4, "totalFieldsSummaryPublisher": 3 }
      }
    }
  ]
}
Önemli detaylar:
- Varlık kontrolleri iç içe ve null-safe:
ctx.containsKey("provenance") && ctx.provenance.containsKey("temporal") && ...— ingest pipeline eksik alanlı dokümanda asla hata fırlatmamalı. - Alan toplamları literal değil
params. Şema değişince script gövdesi değil, parametre değişir. - Sub-level skorlar bedavaya gelir:
score_provenance.originvescore_provenance.temporal,score_provenance.provenanceile aynı geçişte hesaplanır. - Geçici sayaçlar
removeprocessor ile silinir, dokümanlar temiz kalır.
Ağırlıklı overall skor
Son pipeline 8 bölüm skorunu ctx'ten okur (bölüm pipeline'ı bir şey üretmediyse 0 kabul eder) ve birleştirir:
int weightSummary = 7;   int weightDocumentation = 3;
int weightCoverage = 5;  int weightProvenance = 8;
int weightAccessibility = 15; int weightEnrichment = 3;
int weightObservation = 1;    int weightStructuralMetadata = 1;
// totalWeight = 43
ctx.overall_score = (ağırlıklı toplam) / totalWeight;
Accessibility, overall skorun 15/43'ünü taşıyor; çünkü 15 skorlanan alanı var — ağırlıklar birinin fikrini değil, şemanın kendisini yansıtıyor.
Hepsini pipeline processor ile zincirle
main-pipeline, 9 pipeline processor'dan ibaret: bölüm pipeline'ları sırayla, sonda overall-score-pipeline:
PUT datasets/_doc/1?pipeline=main-pipeline
{ "summary": { "title": "..." }, "coverage": { ... } }
Skor ingest pipeline'da hesaplandığı için her index ve update işlemi tüm skorları otomatik yeniden üretiyor — evidence paketindeki örnek doküman skorları bozulmadan _version: 34'teydi. Her sub-pipeline küçük, _simulate ile tek başına test edilebilir ve tek başına değiştirilebilir. pipeline processor mekaniği için Elastic'in ingest pipeline dokümantasyonuna bakabilirsiniz.
Üstüne Kibana
overall_score ve score_* sıradan indexed field olunca dashboard'lar düz Lens grafiklerine dönüştü: publisher başına ortalama kalite skoru (ikinci eksende dataset sayısı), status: FINALIZED filtresiyle organizasyon üyeliği (memberOf: ALLIANCE, HUB, NCS, OTHER) kırılımı ve dashboard üstünde serbest metin arama kutusu — publisher adını yazınca her şey canlı filtreleniyor.
Sonuçlar
Yalnızca evidence paketinin desteklediği kadarı:
| Sonuç | Kanıt |
|---|---|
8 bölüm pipeline'ı + 1 overall, main-pipeline ile zincirli |
Yayınlanan pipeline tanımları |
| Doküman başına 3 skor seviyesi (sub, high, overall) | Skorlanmış örnek doküman |
Örnek dataset skoru: overall_score: 88 |
Pipeline sonrası _source |
| Aynı dokümanda bölüm detayı: summary 100, provenance 85 (origin 100 / temporal 80), accessibility 95, enrichment 33, structural metadata 0 | Skorlanmış örnek doküman |
| Her yazma işleminde skorlar yeniden hesaplanıyor | ?pipeline=main-pipeline; doküman _version: 34 |
| Publisher başına ortalama kalite dashboard'u (95'ten 16'ya inen değerler) | Kibana dashboard ekran görüntüleri |
| Organizasyon (memberOf) bazında kalite kırılımı | Kibana Lens ekran görüntüsü |
İki dürüst dipnot. Birincisi, enrichment'taki 33, Painless integer bölmesiyle 3 alandan 1'inin karşılığı (1 * 100 / 3) — burada kabul edilebilirdi ama yuvarlamanızı bilin. İkincisi, yukarıda gecikme, hacim veya iş KPI'ı yok; çünkü kaynak pakette yoklar ve biz sayı uydurmayız.
Öğrendiklerimiz
- Türetilmiş skoru query anında değil ingest anında hesaplayın. Yazma başına bir kez ödeyin; aggregation sonsuza kadar bedava.
- Tek dev script yerine domain bölümü başına pipeline. Her biri
_simulateile bağımsız test edilir,pipelineprocessor ile değiştirilir. - Ağırlığı hisle değil alan sayısıyla verin. 15 alanlık bölüm, 1 alanlık bölümle aynı sayılmamalı.
- Toplamları
paramsolarak geçin. Şema değişikliği kod değişikliği değil, konfigürasyon değişikliği olsun. - Painless'ta integer bölmeye dikkat.
1 * 100 / 3= 33; 33.3 değil — kesme kabul edilebilir mi, yayına çıkmadan karar verin. - Dashboard'dan önce mapping'i düzeltin.
keywordsub-field yoksa terms aggregation yok — ilk milestone tam bu yüzden takıldı.
Uyumluluk tarzı bir kontrol listesini, ekibin çizip filtreleyebileceği canlı bir doküman skoruna çevirmek isterseniz bu desen her Elasticsearch veya OpenSearch cluster'ında çalışır. Pipeline'lar çalışırken cluster sağlığını da izliyoruz — bkz. searchali.com/tr/monitoring.
İş mantığı taşıyan ingest pipeline'lar için yardım mı lazım? → searchali.com