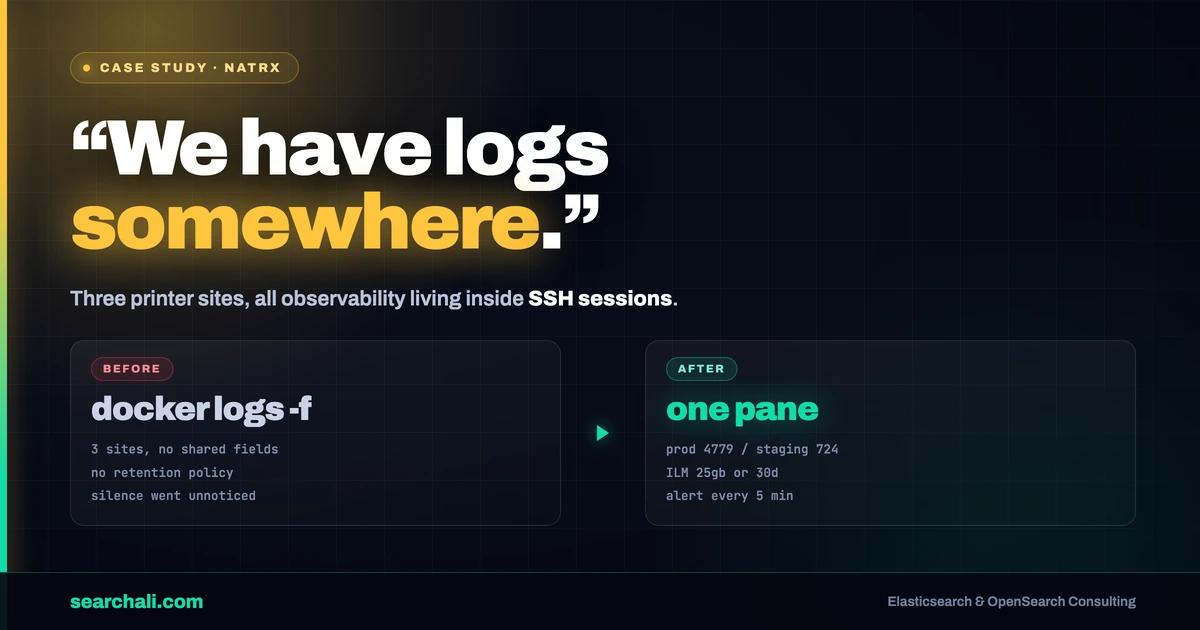
Üç WASP sahası. Edge’de server, frame, pump. Loglar SSH ve docker logs -f içinde. Natrx burada başladı—ve “log bir yerde vardır” observability sayılmadı.
İlk öncelikler netti: güvenlik ve metrikler, Elasticsearch’e güvenilir iletim, production/staging ayrımı, lifecycle ile depolama sınırı, cihaz susunca alarm. Ben de bu hattı Elastic’te kurdum. Aşağısı slayt değil; ILM tanımı, Fleet HEALTHY kontrolü ve indekslenmiş export’taki sayılar.
Sorun
Natrx climate-tech üreticisi; WASP saha üretim yığını: printer server, frame, pump’lar, Raspberry Pi, MQTT/AMQP, VPN → AWS. Asıl sorun operasyonel görünürlük.
Beklenti listesi doğrudan ve doğru yazılmıştı:
- Security ve metrics önce
- Data stream + production/staging ayrımı + lifecycle
- Logstash failure takibi; altyapı health
- Kötü pump / print dashboard; log-yok ve kritik hata alert
- Backup node
Mimari niyet: search ürünü değil — visibility, tracking, alerting (Filebeat, HTTP sensör, app client → ES/Kibana).
Index stratejisi toplantısında o dönemde 3 lokasyon vardı. Her WASP kurulumunda server / frame / pump etiketi planlandı. Sensör verisi çoğu zaman printer’a değil site’a bağlıydı—alan tasarımı bu yüzden kritik.
AWS us-east-2’de ELK zaten m4.large instance olarak duruyordu; yanında Airflow, Traefik ve ilgili servisler. Traefik access log’larında sağlıklı ve gürültülü HTTP karışımı görünüyordu. Eksik olan yeni bir ürün almak değil, Elastic’i edge sağlığının kayıt sistemi yapmaktı.
Teşhis
Üç kırılma noktası tekrar etti.
Yarı yapılandırılmış edge logları. Mesaj gövdesinde JSON benzeri satırlar; dissect/parse olmadan log.level görselleştirmesi ve hata odaklı alert kırılgan kalır. Tokenizer denemeleri sonunda message içinden log.level çıkaran çalışan pattern’e oturduk.
Fleet / Agent topolojisi. Elastic Agent ve Fleet Server kurulumlarında klasik sorunlar: 8220 üzerinde API host timeout, proxy/hosts uyumsuzluğu ve notlara işlenen kural—Fleet Server Elasticsearch ile aynı sunucu yolunda olmazsa enrollment/metrics yolu kopuyor. Host ve policy düzeltmesinden sonra Fleet /api/status HEALTHY döndü. Kurulum artefaktı Elastic Agent 8.7.0; indekslenmiş Filebeat trafiği export’ta 8.5.3.
Disiplinsiz retention. Her şeyi sonsuza kadar tutmak hem maliyeti hem sinyali bozar. Beklentide lifecycle açıkça vardı; bunu ILM olarak kodladık.
Ortam ayrımı da kâğıt üzerinde kalmadı. Filebeat export’unda (5503 doküman) production 4779, staging 724; component olarak server 4173, frame 724, pumps 606. Pump dashboard vaadinden önce görmek istediğiniz şekil budur.
Çözüm
Pipeline’ı hop hop sözleşmeyle kurduk.
Ingest
Edge’de Filebeat → Logstash. Logstash Docker’da Beats input 5044, gerektiğinde grok + date (@timestamp, America/New_York), Elasticsearch output. Logstash container log’larını takip etmek, “failure’ları izle, drop etme” beklentisiyle birebir örtüşüyor.
Domain modeli
Lokasyon başına dataset; server / frame / pump tag. Toplantı aksiyonları: JSON alan parse (time, level, name, message), log.level bar chart, HQ/mini gibi birden fazla dataset.
Operatör için parse
Dissect ile message içinden log.level. Küçük bir tokenizer; büyük filtreleme gücü.
Lifecycle
filebeat-general ILM:
- Hot: primary shard 25gb veya 30d rollover
- Delete: 365d
wasp-logs index template filebeat-* pattern’ini bu lifecycle’a bağladı. “Saklanan veri miktarını sınırla” maddesinin somut cevabı bu.
Fleet
Status HEALTHY; gerektiğinde policy elle; doğru Fleet URL/host. Fleet’i ES ile co-locate etmek, “Elastic çöktü” sanılan bir sınıf dial/timeout’u ortadan kaldırdı.
Alert
Rules & Connectors: 5 dakikada bir bak; o node’dan veri yoksa bildir. “Bir süre log gelmiyor” beklentisinin operasyonel hali.
Dashboard yönü
Component ve printer alanları varken “hangi pump kötü?” ve “bu print’te ne oldu?” soruları CSV avına dönmeden Kibana’da cevaplanır. Security tarafı: ne mümkün öğren, low-hanging fruit uygula—tek seferde tam SOC değil.
Yayında token, fingerprint, özel IP yok. Kamuya kalan pattern: doğru Fleet hosts, gereken yerde Fleet/ES co-location, HEALTHY doğrula, sonra metriklerin gerçekten geldiğini teyit et.
Sonuçlar
Yalnızca kanıtlı tablo:
| Sonuç | Kanıt |
|---|---|
| 3 WASP lokasyonu, site bazlı dataset planı | Toplantı notları |
| Production / staging ayrımı indekste görünür | 4779 / 724 (5503 dokümanlık export) |
| Component etiketleri canlı | server 4173; frame 724; pumps 606 |
| ILM saklama zarfı | 25gb veya 30d rollover; 365d delete |
| Fleet control plane sağlıklı | /api/status → HEALTHY |
| No-data algılama ritmi | Her 5 dakika |
| AWS ELK compute | m4.large, us-east-2 |
İddia etmiyoruz: uydurma latency %, storage cost %, MTTR. Kaynak paketinde yok.
Ürün bağlamındaki coastal armoring malzeme rakamları iç materyalde ekranlar arasında çelişkili; Elastic KPI’sı değildir, sonuçlara girmez.
Öğrendiklerimiz
- Önce fiziksel topolojiyi etiketle. Server / frame / pump olmadan “kötü pump” dashboard’u spekülasyondur.
- Ortamı index’e yaz. Production 4779 / staging 724 — ayrım field olunca ölçülür.
- ILM’i ürün maddesi say. 25gb veya 30g rollover, 365g delete; depolama limiti böyle kodlanır.
- Fleet HEALTHY ≠ metrics. Co-location ve host/proxy yanlışsa agent “ayakta”, telemetri yok.
- Yokluğa bas. 5 dakikada bir no-data kuralı, edge filoda çoğu CPU panelinden daha işe yarar.
Loglarınız hâlâ docker logs -f ise pattern bu: edge shipper, net alanlar, lifecycle, doğru Fleet, sessizlikte çalan alert. Lifecycle için Elastic’in ILM dokümantasyonuna bakın.
Kendi filonuz için observability’yi sağlamlaştırmak ister misiniz? → searchali.com