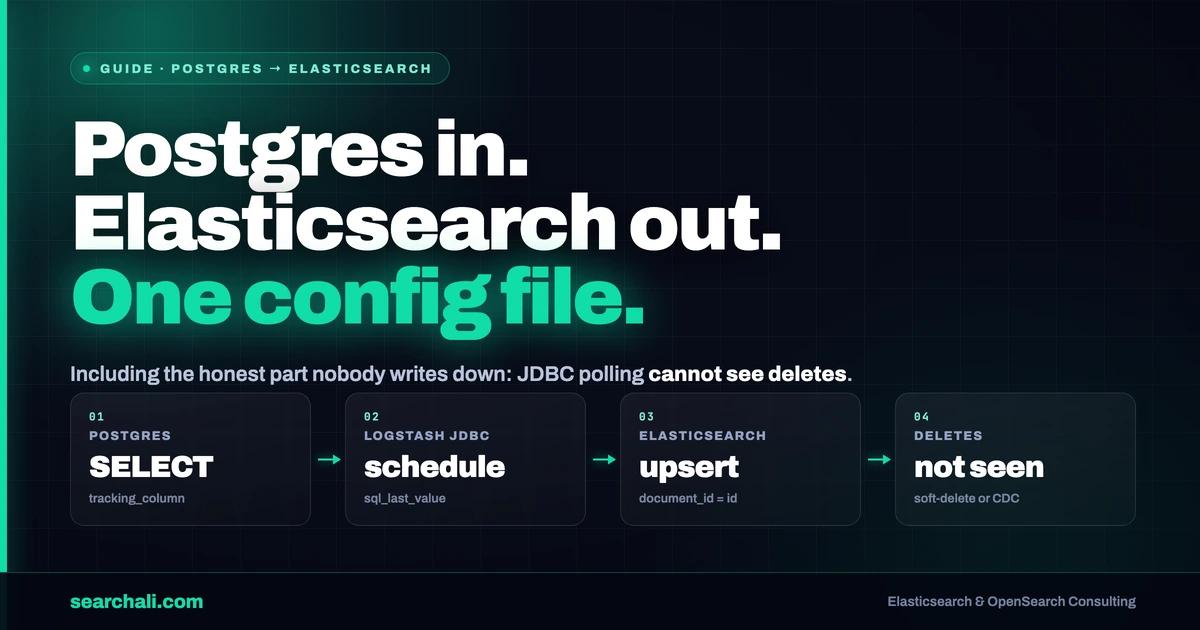
Veriniz PostgreSQL'de, ama full-text arama, aggregation ve Kibana dashboard'ları istiyorsunuz. Başlamak için Kafka'ya, Debezium'a veya özel bir ETL servisine gerek yok: Logstash'in JDBC input'u bir SQL cümlesini zamanlanmış bir sync pipeline'ına çevirir.
Bu rehber, tam olarak bu akışı gösterdiğim çalışan bir lab'dan geliyor: Docker'da PostgreSQL (klasik world örnek veritabanı yüklü), Elastic'in resmi Docker Compose'uyla TLS'li 3 node'lu Elasticsearch + Kibana ve her dakika JDBC üzerinden satır çeken Logstash 8.4.0. Aşağıdaki her config gerçek; sadece parolalar placeholder ile değiştirildi.
Kısa cevap: PostgreSQL JDBC driver jar'ını Logstash'e kopyalayın, jdbc input'a bir SQL statement ve cron schedule verin, elasticsearch output'ta document_id => "%{id}" ayarlayın ki tekrar eden çalıştırmalar duplicate yerine update üretsin. Sadece ekleme yapılan tablolarda WHERE id > :sql_last_value + tracking_column ile artımlı sync kurun. Dürüst uyarı: JDBC input delete'leri göremez — bunun için ayrı plan gerekir.
Mimari
Üç parça, her biri kendi container'ında veya process'inde:
- PostgreSQL — örnek veri
docker-entrypoint-initdb.dile image'a gömülü. - Elasticsearch + Kibana — Elastic'in get-started
docker-compose.yml'ı: bir setup container'ı CA ve node sertifikalarını üretir, üç ES node security açık gelir, Kibana 5601'de. - Logstash — JDBC input'u schedule ile çalıştırıp sonuçları bulk indexler.
Postgres tarafı dört satırlık bir Dockerfile:
FROM postgres
ENV POSTGRES_PASSWORD <your-password>
ENV POSTGRES_DB world
COPY world.sql /docker-entrypoint-initdb.d/
docker build -t my-postgres-db ./
docker run -d --name my-postgresdb-container -p 5432:5432 my-postgres-db

# kontrol
docker exec -it my-postgresdb-container psql -U postgres -d world -c "\dt"
docker exec -it my-postgresdb-container psql -U postgres -d world -c "SELECT * FROM country"
Elasticsearch ve Kibana için Elastic'in resmi Docker Compose rehberini kullanın — docker-compose up -d ile TLS ve authentication hazır gelir. Cluster HTTPS konuştuğu için üretilen CA'yı container'dan dışarı alın:
docker cp <es-container>:/usr/share/elasticsearch/config/certs/ca/ca.crt /tmp/ca.crt
curl -u elastic:<your-password> https://localhost:9200 --cacert /tmp/ca.crt
Logstash JDBC input kurulumu
Logstash veritabanı driver'larını kendisi taşımaz. PostgreSQL JDBC jar'ını indirip Logstash'in görebileceği yere koyun (alternatif: jdbc_driver_library parametresi):
wget https://artifacts.elastic.co/downloads/logstash/logstash-8.4.0-darwin-x86_64.tar.gz
tar -xvf logstash-8.4.0-darwin-x86_64.tar.gz
cp postgresql-42.3.3.jar logstash-8.4.0/logstash-core/lib/jars/postgresql-jdbc.jar
./logstash-8.4.0/bin/logstash -f logstash.conf
Çalışan pipeline'ın tamamı, sanitize edilmiş hali:
input {
    jdbc {
        jdbc_connection_string => "jdbc:postgresql://localhost:5432/world"
        jdbc_user => "postgres"
        jdbc_password => "<your-password>"
        jdbc_driver_class => "org.postgresql.Driver"
        statement => "SELECT * FROM country"
        schedule => "* * * * *"
    }
}

filter { }

output {
    stdout { }
    elasticsearch {
        ssl => true
        hosts => ["https://localhost:9200"]
        index => "country"
        user => "elastic"
        password => "<your-password>"
        document_id => "%{id}"
        cacert => "/tmp/ca.crt"
    }
}
İşin çoğunu iki satır yapıyor. schedule standart cron: * * * * * her dakika; lab'da saatlik varyant 0 * * * * da çalıştı. document_id => "%{id}" ise primary key'i Elasticsearch _id'sine bağlar — tekrarlanan çalıştırmaları idempotent yapan şey bu. stdout output geliştirme sırasında dostunuz; production'da kaldırın. Tüm parametreler için Logstash JDBC input dokümantasyonu.
Artımlı sync: üç gerçek senaryo
Küçük tablolarda her dakika SELECT * FROM table çekmek sorun değil. Sonrası için strateji gerekir. Lab notlarındaki üç pattern:
Senaryo 1: sadece ekleme yapılan, id'li tablo
Satırlar yalnızca insert ediliyor, update yok. En son görülen id'yi sql_last_value ile takip edin:
input {
  jdbc {
    statement => "SELECT id, col1, col2 FROM my_table WHERE id > :sql_last_value"
    use_column_value => true
    tracking_column => "id"
    # ... bağlantı ayarları
  }
}
Her zamanlanmış çalıştırmada Logstash, sakladığı sql_last_value'yu (.logstash_jdbc_last_run dosyası) sorguya koyar ve sadece yeni satırları çeker. tracking_column olarak timestamp tipinde bir updated_at kolonu kullanırsanız update'leri de yakalarsınız — uygulamanız o kolonu güvenilir güncelliyorsa.
Senaryo 2: satırlar update ediliyor
Her seferinde tüm veriyi çekin ama document id'yi sabitleyin:
output {
    elasticsearch {
        document_id => "%{id}"
        # ... diğer ayarlar
    }
}
_id sabit olduğu için yeniden indexlenen satırlar duplicate üretmez, eski dokümanın üzerine yazar. Tablo büyüyüp full re-pull pahalanana kadar en basit doğru çözüm.
Senaryo 3: primary key yok
Kolonları birleştirip sentetik id üretin: document_id => "%{col1}-%{col2}". Kombinasyonun gerçekten unique olduğundan emin olun; değilse satırlar sessizce birbirinin üstüne yazılır.
Dürüst kısım: delete'ler
JDBC input SQL sorgusu çalıştırır. Silinen satır sonuçlarda görünmez olur — Logstash onun varlığından hiç haberdar olmaz ve bayat doküman Elasticsearch'te sonsuza kadar kalır. Seçenekler, artan efor sırasıyla:
- Soft delete: satırı silmek yerine
deletedflag kolonu ekleyin, senkronlayın, sorgu tarafında filtreleyin (veya output'ta delete aksiyonunu bu alanla tetikleyin). - Periyodik rebuild: belirli aralıklarla taze bir index'e reindex edip alias swap yapın — bayat dokümanlar her swap'ta temizlenir.
- Gerçek CDC: delete'lerin neredeyse gerçek zamanlı yansıması gerekiyorsa change-data-capture'a geçin (Postgres WAL'ı okuyan Debezium + Kafka). Daha fazla altyapı, ama her insert/update/delete'i görür.
Delete nadirse ve bir gün gecikme tolere edilebiliyorsa alias-swap rebuild pragmatik cevaptır. JDBC input'un bunu hallettiğini varsaymayın — halletmiyor.
Veriyi Elasticsearch'te doğrulama
country ve city index'leri dolunca kazanç, Postgres'in extension'sız veremeyeceği sorgu esnekliği:
GET city/_search
{
  "query": {
    "bool": {
      "must": [
        { "match": { "name.keyword": "Cambridge" } },
        { "range": { "population": { "gte": 110000 } } }
      ]
    }
  }
}
name.keyword üzerinde terms aggregation, Cam* gibi wildcard sorguları ve Query DSL'in geri kalanı artık ilişkisel verinizin üzerinde çalışıyor. En hızlı konsol Kibana Dev Tools (5601). Pipeline canlıya çıktıktan sonra indexing rate ve rejection'ları diğer ingest hatları gibi izleyin — tam olarak Elasticsearch monitoring sayfasında anlattığımız iş.
Bu rehberde throughput/latency benchmark'ı yok: kaynak lab ölçmedi, ben de sayı uydurmam.
Sık Sorulan Sorular
Logstash JDBC input ne sıklıkta çalışmalı?
schedule cron sözdizimi kabul eder: her dakika (* * * * *), saatlik (0 * * * *) veya gecelik. Arama sonuçlarının ne kadar taze olması gerektiğine ve veritabanınızın yük toleransına göre seçin. Saniye altı tazelik gerekiyorsa JDBC polling yanlış araçtır; CDC'ye bakın.
JDBC input silinen satırları görür mü?
Hayır. SQL poll, artık var olmayan satırları göremez. Soft-delete flag, alias arkasında zamanlanmış full reindex veya delete'lerin Elasticsearch'e ulaşması şartsa CDC pipeline (Debezium/Kafka) kullanın.
Dokümanlarım neden her çalıştırmada duplicate oluyor?
document_id ayarlamamışsınız. O olmadan Elasticsearch her bulk isteğinde otomatik _id üretir ve her zamanlanmış çalıştırma taze kopyalar ekler. Primary key'i document_id => "%{id}" ile bağlayın.
sql_last_value nerede saklanıyor?
Bir metadata dosyasında (varsayılan: Logstash kullanıcısının home'unda .logstash_jdbc_last_run; last_run_metadata_path ile değiştirilebilir). Baştan full sync zorlamak için o dosyayı silin.
Öğrendiklerimiz
- Bir jar, bir config dosyası — Postgres verisini aranabilir yapmak için gerçekten bu kadarı yetiyor: JDBC driver'ı Logstash'e kopyala,
jdbcinput yaz. document_id'yi her zaman primary key'den ayarlayın. Idempotent sync ile duplicate dolu index arasındaki fark bu.- Append-only veya timestamp takipli tablolarda
sql_last_value+tracking_columnkullanın; tüm tabloyu her dakika çekmeyin. - Delete'ler JDBC polling ile asla yansımaz — soft delete, alias-swap rebuild veya CDC arasında baştan karar verin.
- Geliştirmede
stdout {}output'u açık tutun, production'da kaldırın. - Modern Elasticsearch'te TLS opsiyonel değil — cluster CA'sını (
ca.crt) container'dan alın, output'tacacertile referans verin.
Bu pattern'i gerçek ölçekte mi çalıştırıyorsunuz, yoksa JDBC polling mi CDC mi emin değil misiniz? searchali.com üzerinden ulaşın.